
GitHub - | edwardyoon/focus-llama: Ein Fork von llama.cpp für Dynamic Attention Masking
github.com/edwardyoon/focus-llama

Details zur Berichterstattung
| Zuletzt aktualisiert | |
| Artikel gesamt | 1 |
Hauptthemen


neues Programm, das auf dem Quellcode eines anderen basiert
Ähnliche Artikel
Previous
GitHub – achyudh/llama.cpp: LLM-Inferenz in C/C++: LLM-Inferenz in C/C++. Tragen Sie zur Entwicklung von achyudh/llama.cpp bei, indem Sie ein Konto auf GitHub ...
github.com/achyudh/llama.cpp


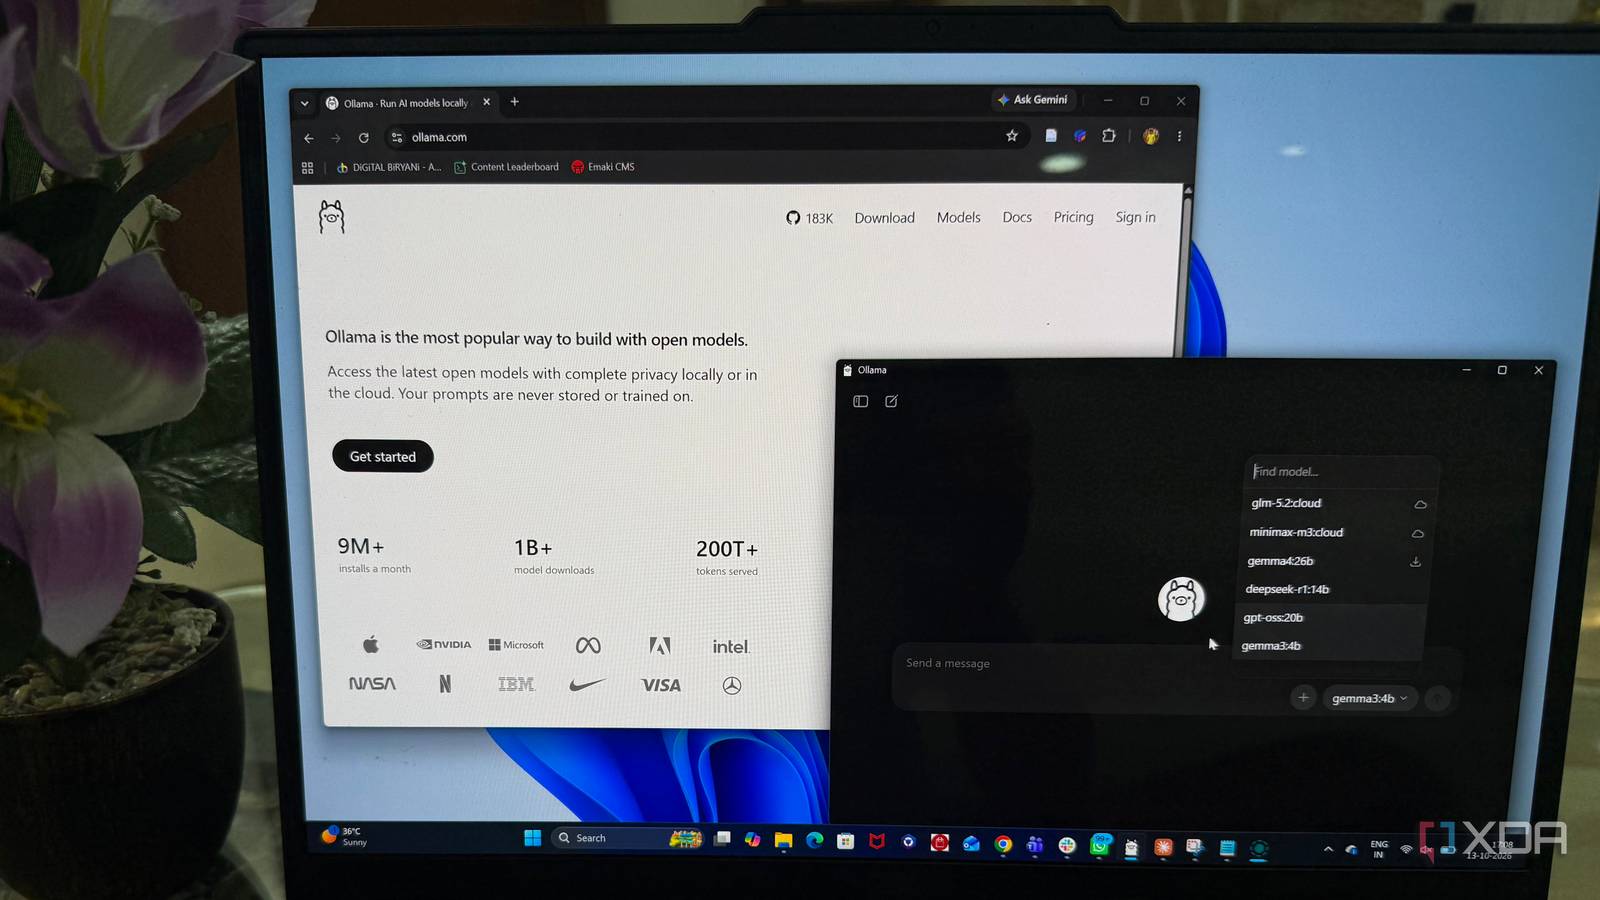
Ollama ist der einfachste Weg, mit lokaler KI zu beginnen, und es ist auch das Erste, was ich ersetzen würde.
xda-developers.com/ollama-easiest-way-start-with-local-ai-its-also-first-thing-id-replace/
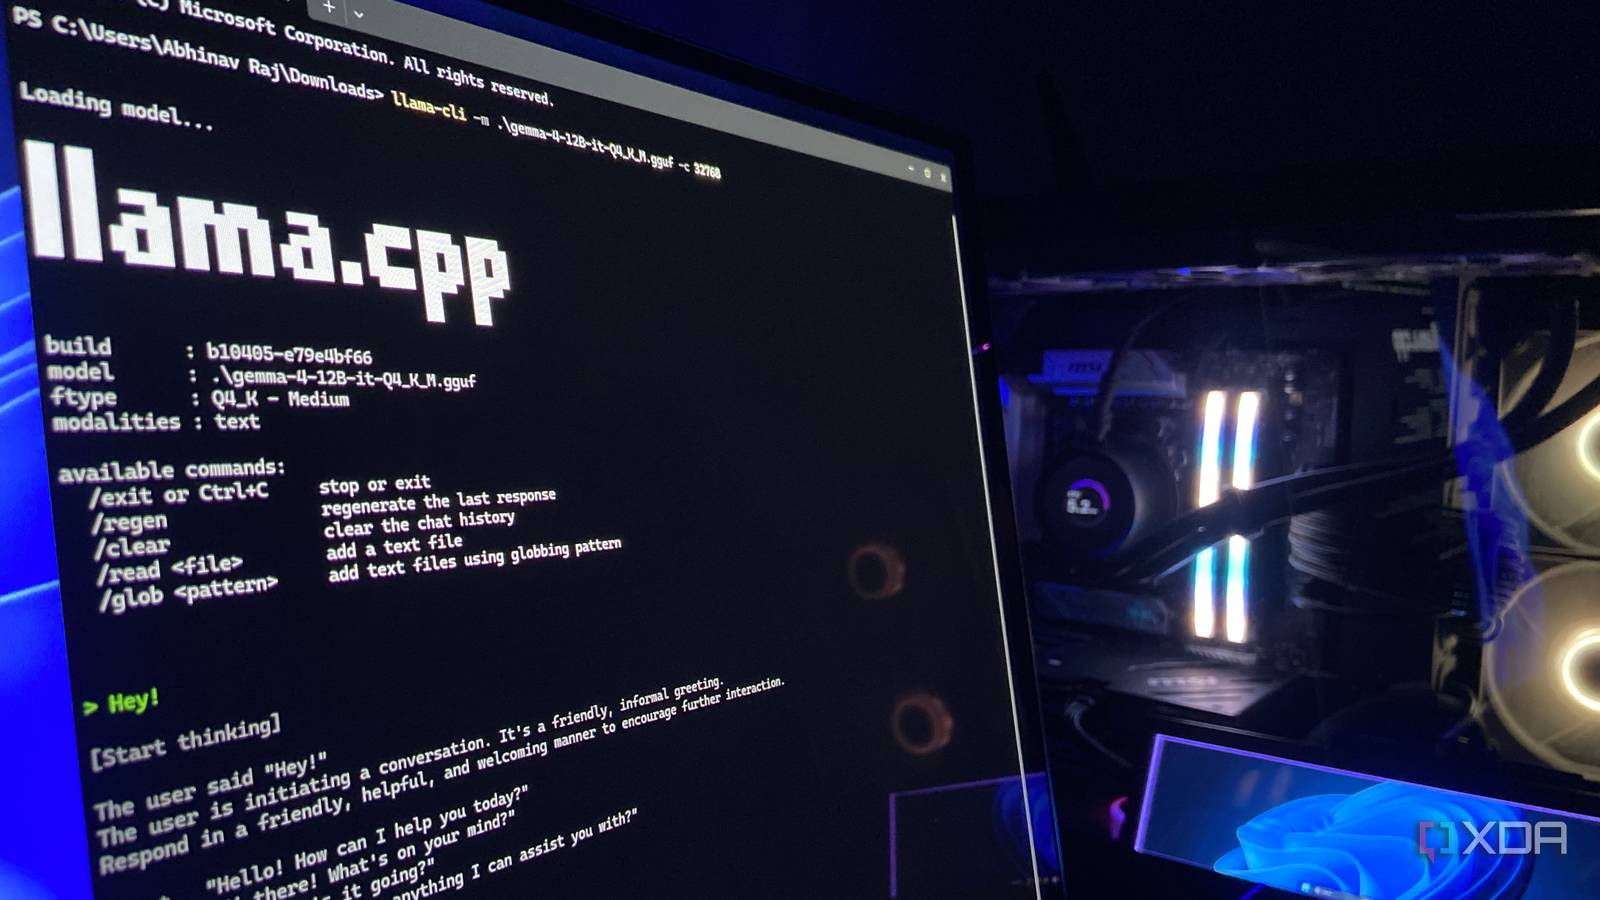
Ich habe meine lokalen Modelle von Ollama nach llama.cpp verschoben, und der Grund dafür hat nichts mit Geschwindigkeit zu tun.
xda-developers.com/i-moved-from-ollama-to-llamacpp-and-discovered-its-better-than-most-tools/
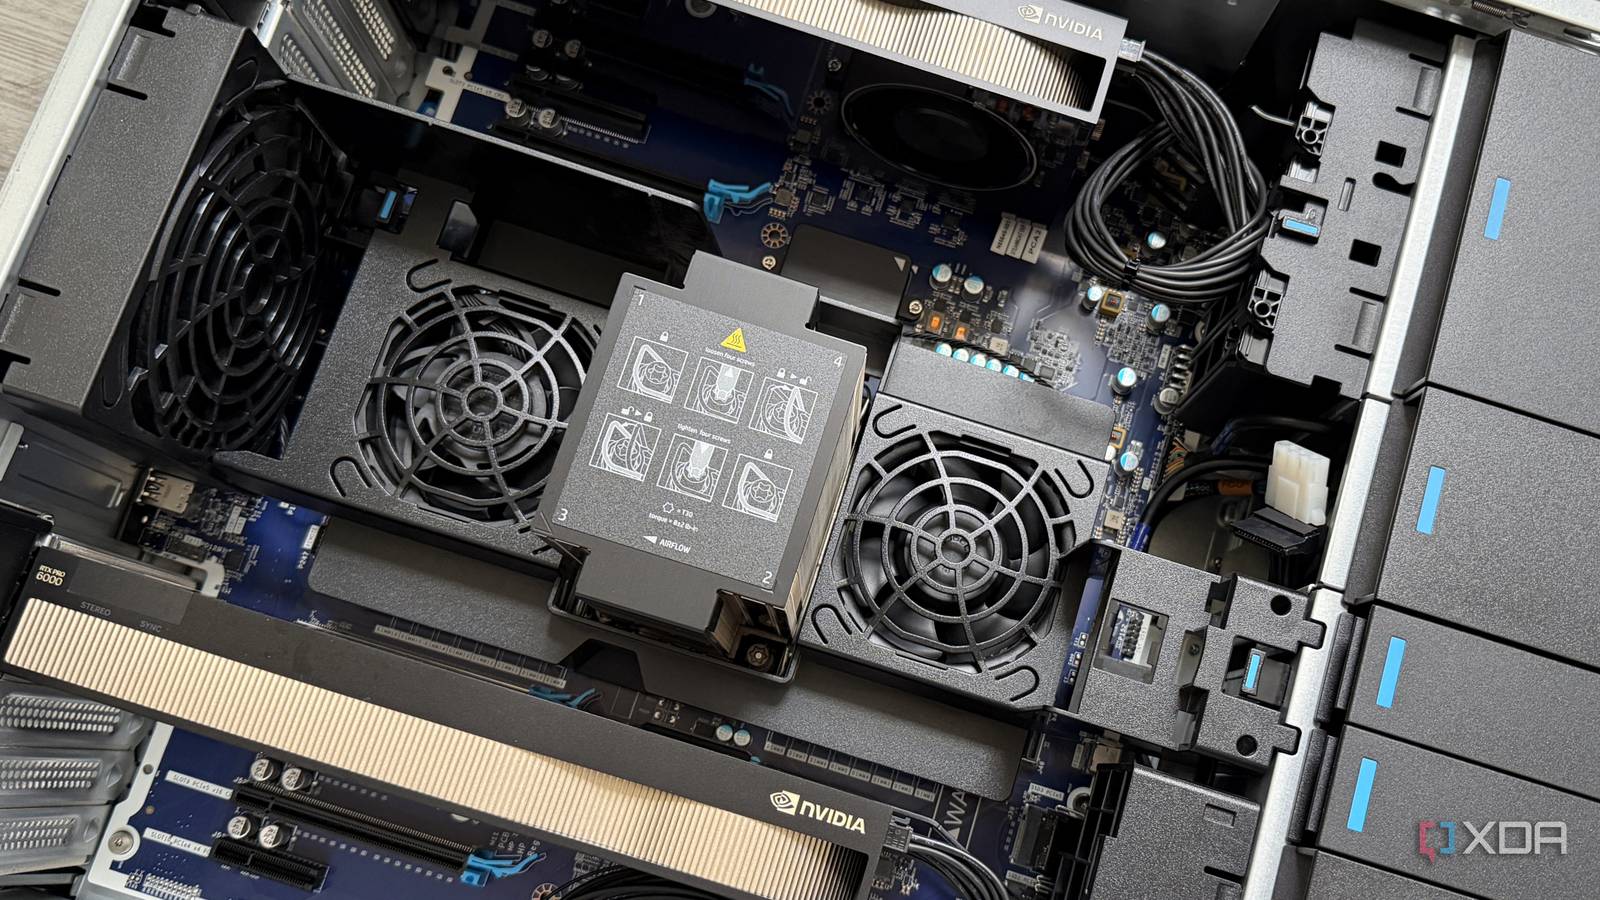
Ich habe GLM 5.3, ein Modell mit 744 Milliarden Parametern, in meinem Heimnetzwerk ausgeführt, und die Grenzen des Möglichen scheinen plötzlich viel näher.
xda-developers.com/you-can-run-a-744b-model-on-your-own-hardware/
GitHub - | hardenedlinux/SonicBoom: Beteilige dich an der Entwicklung von hardenedlinux/SonicBoom, indem du ein Konto auf GitHub erstellst.
github.com/hardenedlinux/SonicBoom

Laufzeitunterstützung für Prism Bonsai 2 27B von bri-prism · Pull Request #29600 · ggml-org/llama.cpp
github.com/ggml-org/llama.cpp/pull/29600

open-jet/megakernel at master · L-Forster/open-jet: Lokaler Codierungsagent + Modelllaufzeitumgebung. Bedient Qwen3.8-27B 1,5x schneller als llama ...
github.com/L-Forster/open-jet/tree/master/megakernel
focus-llama/README.md auf master · edwardyoon/focus-llama: Ein llama.cpp-Fork für Dynamic Attention Masking. Beteilige dich an der Entwicklung von ...
github.com/edwardyoon/focus-llama/blob/master/README.md

GitHub - | atretador/gfx906-16gb-expert-pool: LLM-Inferenz in C/C++: LLM-Inferenz in C/C++. Tragen Sie zur Entwicklung von atretador/gfx906-16gb-expert-pool bei ...
github.com/atretador/gfx906-16gb-expert-pool

GitHub - | ccebelenski/localagents: MCP-Server, der die Arbeit des Claude-Code-Agenten an lokale Modelle (llama.cpp / vLLM) auf Ihrer eigenen Hardware ...
github.com/ccebelenski/localagents

Server: Korrektur der Checkpoint-Erstellung durch jacekpoplawski · Pull Request #22929 · ggml-org/llama.cpp
github.com/ggml-org/llama.cpp/pull/22929

lucebox-hub/megakernel at main · Luce-Org/lucebox-hub: Lucebox Optimization Hub: Handoptimierte LLM-Inferenz, entwickelt für spezifische Consumer-Hardware ...
github.com/Luce-Org/lucebox-hub/tree/main/megakernel

llama.cpp/docs/backend/snapdragon/README.md at master · ggml-org/llama.cpp: LLM-Inferenz in C/C++. Beteiligen Sie sich an der Entwicklung von ggml-org/llama.cpp ...
github.com/ggml-org/llama.cpp/blob/master/docs/backend/snapdragon/README.md

GitHub - | ParmesanParty/llama.cpp: Spezialisierter Fork für (relativ) schnelle Single-GPU-Inferenz (in CUDA) mit großen MoE-Modellen ...
github.com/ParmesanParty/llama.cpp
GitHub - | ag88/llama.cpp-model-runner: runmodel.sh ein einfacher Modellstarter für llama.cpp / llama-server
github.com/ag88/llama.cpp-model-runner

Next