Ich habe LM Studio gegen llama.cpp getauscht, und mein lokales LLM fühlt sich nicht mehr wie ein Rückschritt an.
xda-developers.com/ditched-lm-studio-for-llama-cpp-and-local-llm-doesnt-feel-like-downgrade-anymore/

Details zur Berichterstattung
| Zuletzt aktualisiert | |
| Artikel gesamt | 1 |
Hauptthemen


Sprachmodell, das mit großen Mengen von Texten erstellt wurde

Ähnliche Artikel
Previous

GitHub – achyudh/llama.cpp: LLM-Inferenz in C/C++: LLM-Inferenz in C/C++. Tragen Sie zur Entwicklung von achyudh/llama.cpp bei, indem Sie ein Konto auf GitHub ...
github.com/achyudh/llama.cpp


Ich zahle keine 20 $ für ChatGPT oder Claude, weil ein kostenloser lokaler LLM alles kann, was ich brauche.
xda-developers.com/im-not-paying-20-for-chatgpt-claude-or-gemini-because-a-free-local-llm-does-everything-i-need/

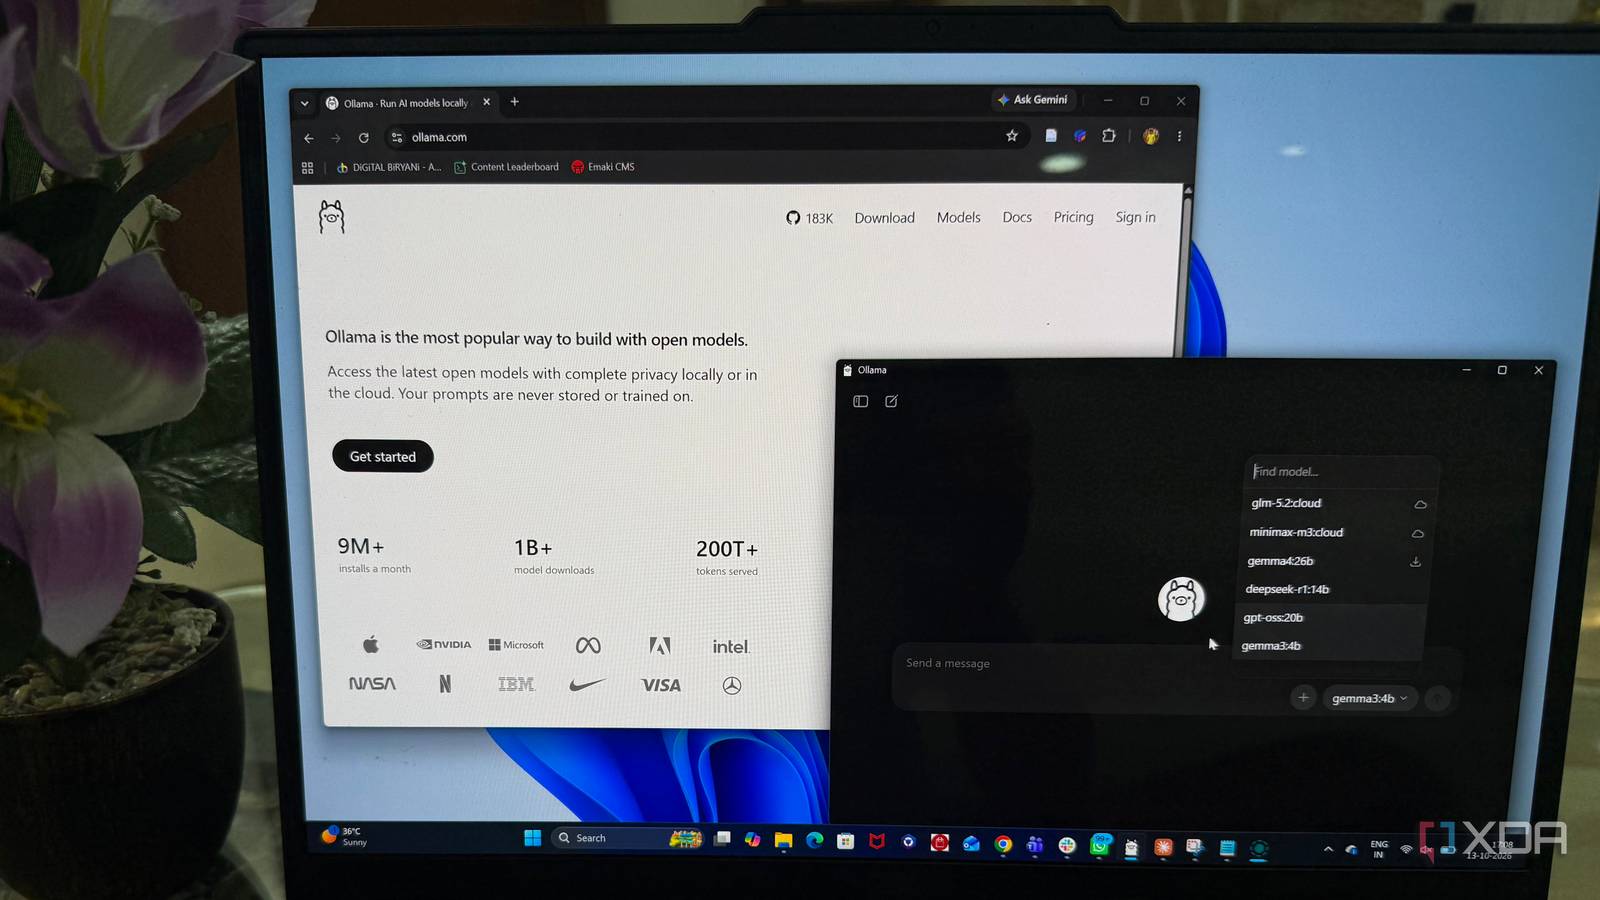
Ollama ist der einfachste Weg, um mit lokaler KI zu beginnen, und es ist auch das Erste, was ich ersetzen würde
xda-developers.com/ollama-easiest-way-start-with-local-ai-its-also-first-thing-id-replace/
Modell: MTP-Unterstützung für Mellum 2.1 von Xarbirus · Pull Request #30612 · ggml-org/llama.cpp
github.com/ggml-org/llama.cpp/pull/30612

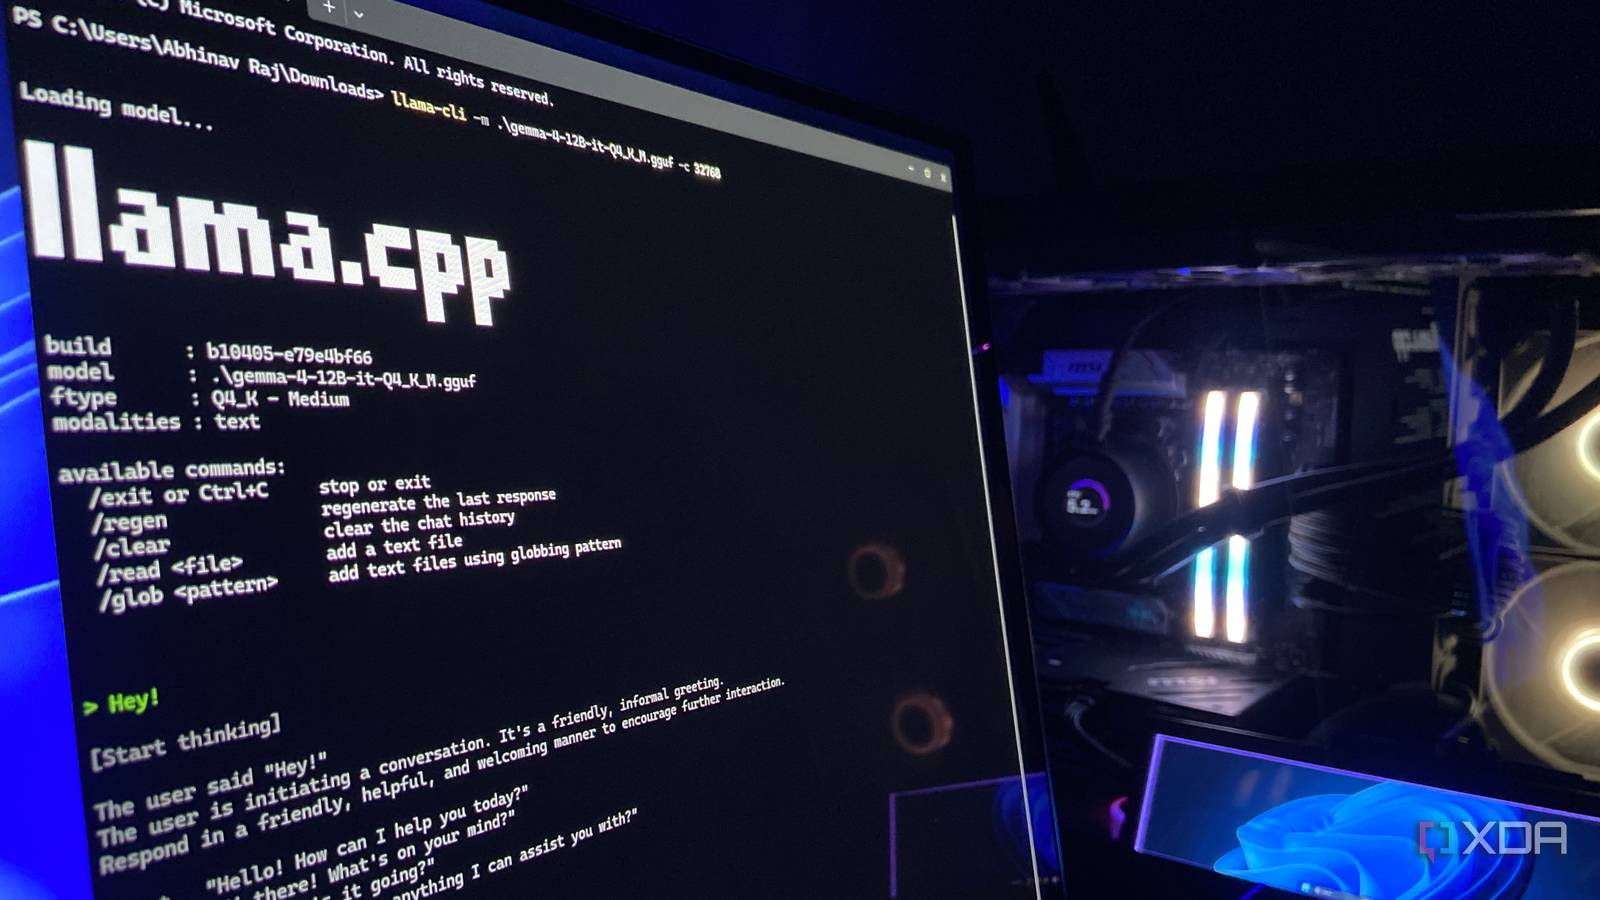
Ich habe meine lokalen Modelle von Ollama nach llama.cpp verschoben, und der Grund dafür hat nichts mit Geschwindigkeit zu tun.
xda-developers.com/i-moved-from-ollama-to-llamacpp-and-discovered-its-better-than-most-tools/
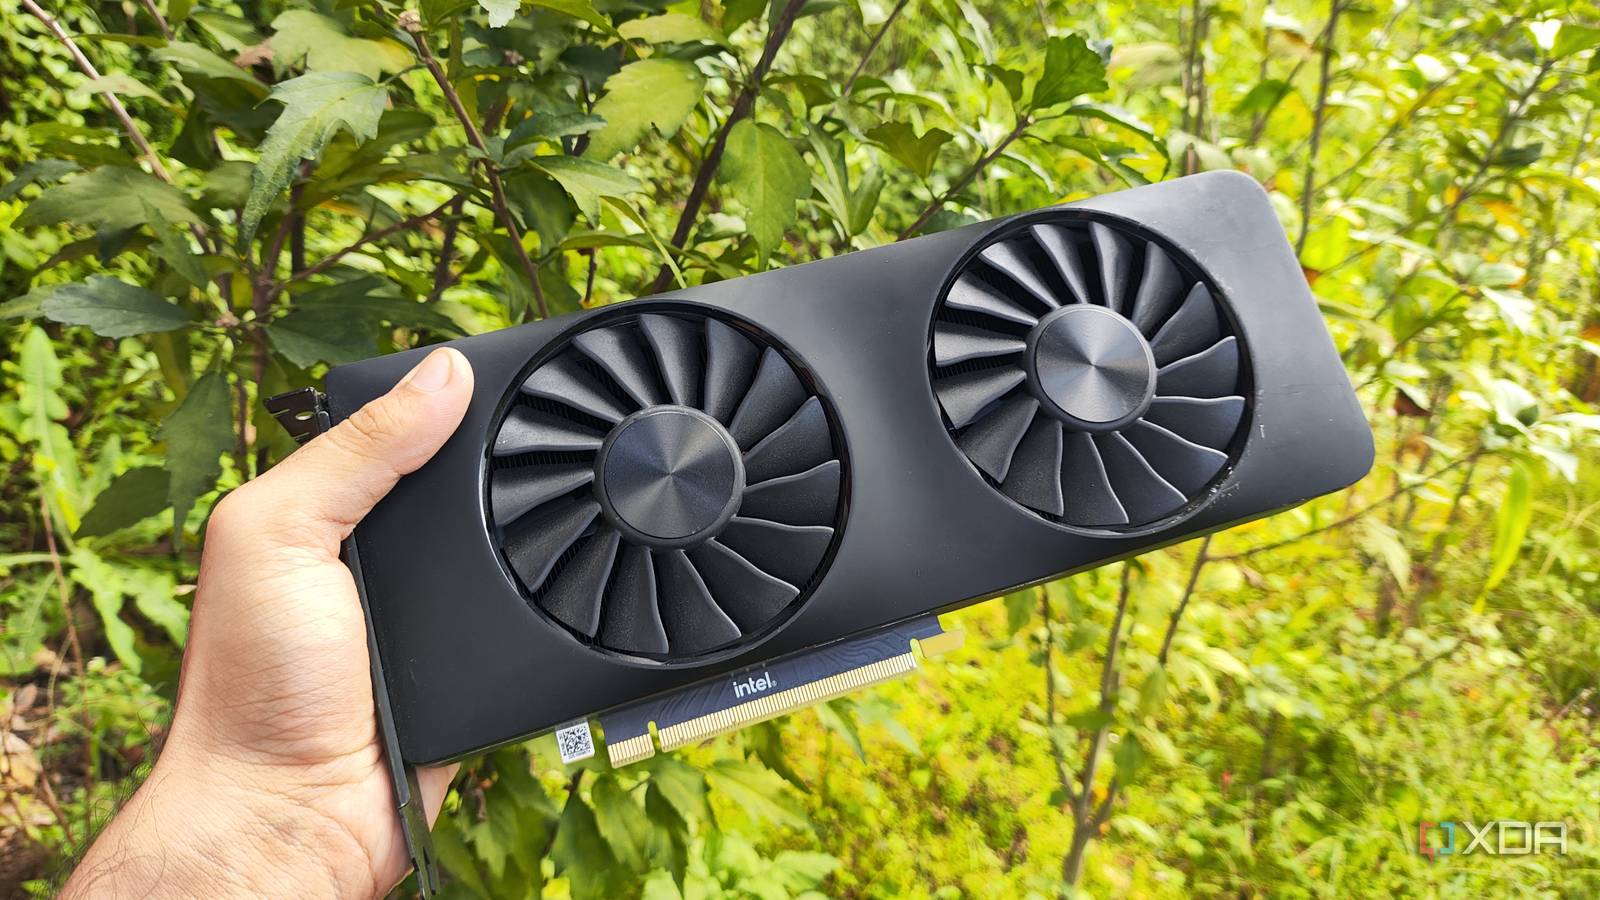
Ich habe eine alte Intel Arc-Karte für einen lokalen LLM-Server wiederverwendet, und die Ergebnisse waren überraschend gut
xda-developers.com/i-recycled-an-old-intel-arc-card-to-run-local-llms-and-the-results-were-surprisingly-decent/
GitHub - | ChrystianSchutz/ThreadShelf: Lokales Archiv, semantische Suche und Fortsetzung von KI-Konversationen in ChatGPT, Claude, Gemini, Grok, OpenRouter ...
github.com/ChrystianSchutz/ThreadShelf

Ich habe meinen alten Windows 10 Gaming-PC als llama.cpp-Server wiederbelebt, und er ist gut genug für alltägliche Produktivitätsanwendungen.
xda-developers.com/i-revived-my-old-windows-10-gaming-pc-as-a-llamacpp-server/
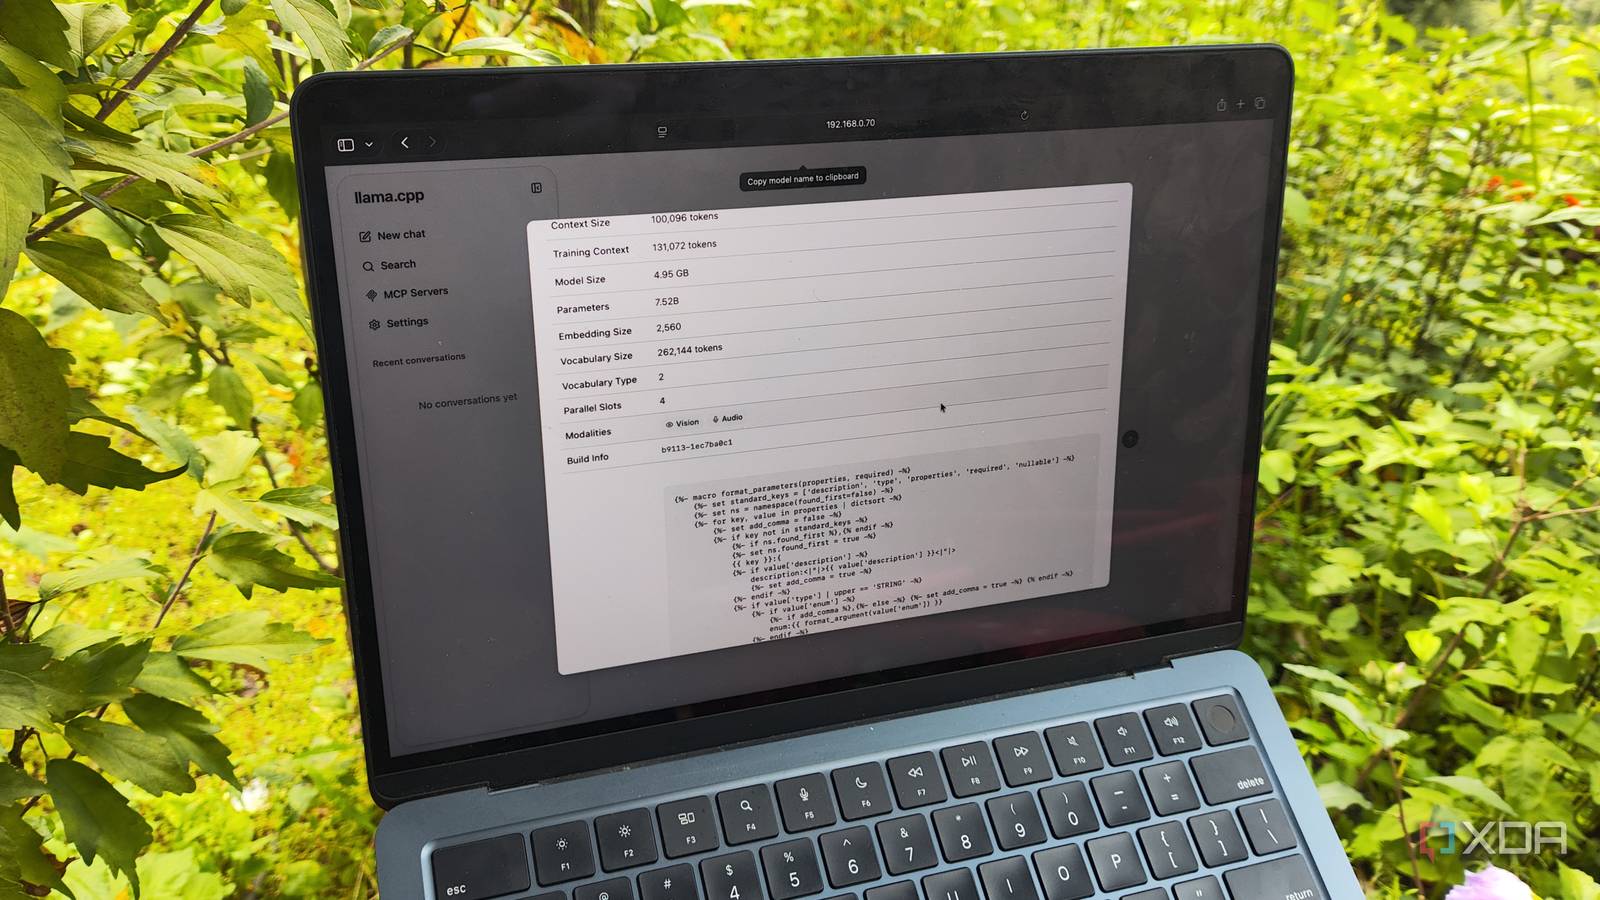
Ich habe mein altes Handy in einen lokalen LLM-Server verwandelt, und es erledigt Produktivitätsaufgaben besser als erwartet.
xda-developers.com/i-turned-my-old-phone-into-a-local-llm-server/

GitHub - | noreff/lmstudio-dsv4-patch: Laden Sie antirez' DeepSeek V4 Flash llama.cpp-Fork in LM Studio (Mac, 128 GB Arbeitsspeicher) ...
github.com/noreff/lmstudio-dsv4-patch

Ollama ist der einfachste Weg, lokale LLMs zu starten, aber diese 6 Alternativen sind ebenfalls einen Versuch wert.
xda-developers.com/ollama-alternatives-worth-trying/
Ich habe lokale LLMs auf Intels günstigster iGPU ausgeführt, und die Ergebnisse waren überraschend gut.
xda-developers.com/i-tried-running-llms-on-intels-cheapest-igpu/
Ich habe LM Studio gegen eine Open-Source-Alternative getauscht – und mein lokales Modell kann jetzt Dinge, die vorher unmöglich waren.
xda-developers.com/ditched-lm-studio-for-open-source-alternative/
Ich habe endlich ein lokales Open-Source-LLM gefunden, das tatsächlich mit Cloud-KI mithalten kann
xda-developers.com/found-open-source-local-llm-that-competes-with-cloud-ai-gemma-4/
llama : Gemma4 MTP von am17an hinzufügen · Pull Request #23398 · ggml-org/llama.cpp
github.com/ggml-org/llama.cpp/pull/23398

Ich habe endlich ein lokales Open-Source-LLM gefunden, das tatsächlich mit Cloud-KI mithalten kann
xda-developers.com/found-open-source-local-llm-that-competes-with-cloud-ai-gemma-4/
Ich habe einen lokalen LLM-Server aufgebaut, auf den ich von überall zugreifen kann, und er nutzt einen Raspberry Pi
xda-developers.com/i-built-a-local-llm-server-i-can-access-from-anywhere/
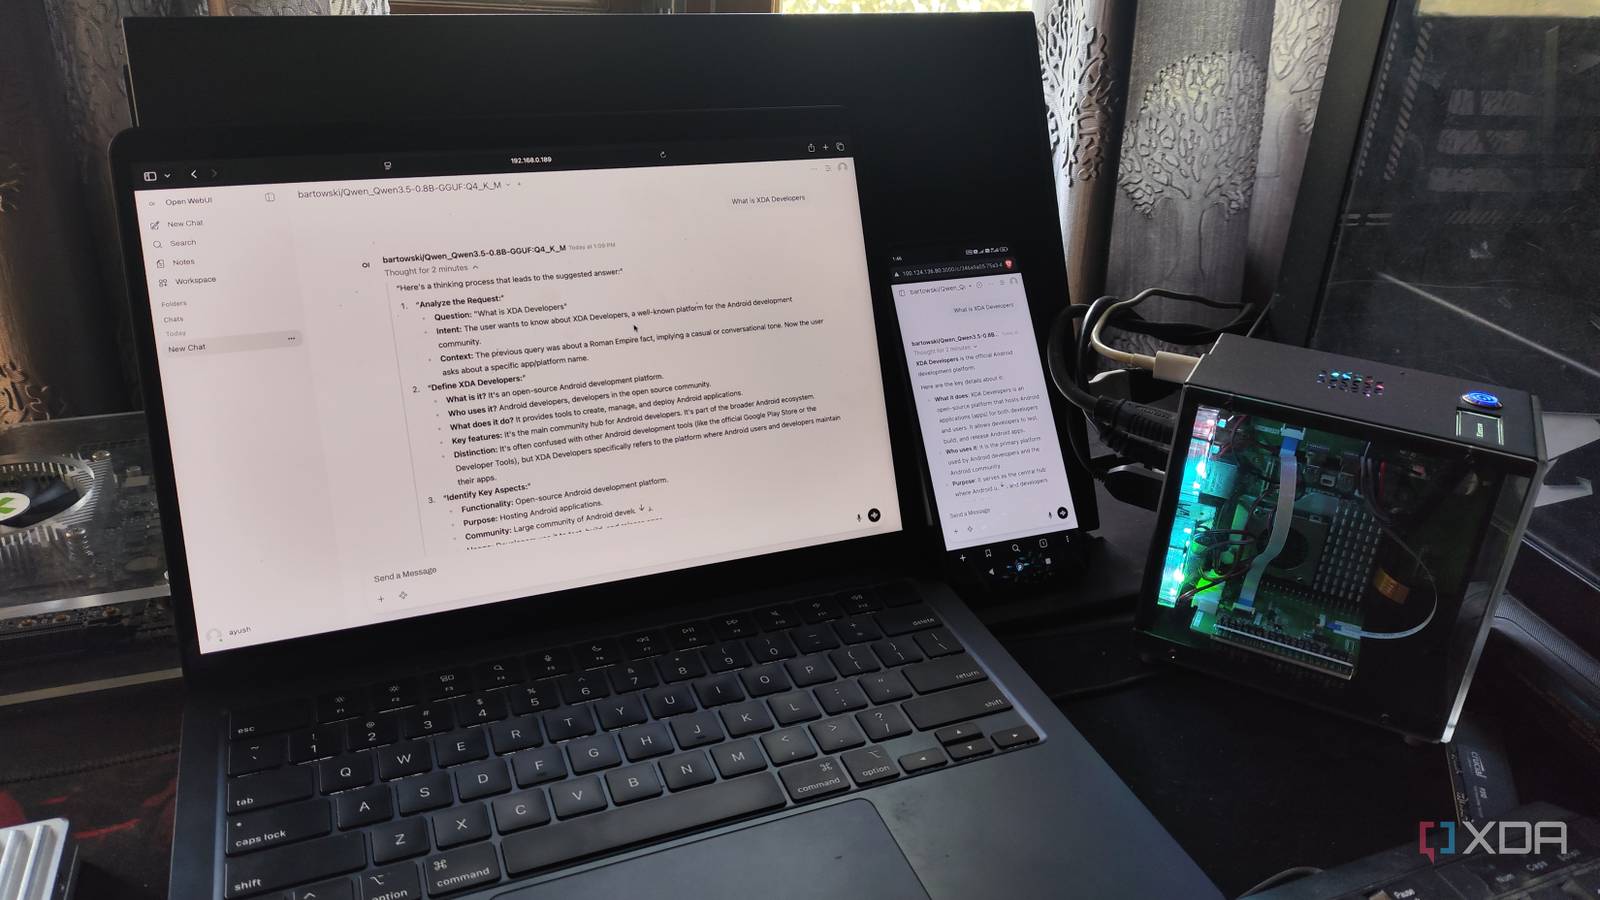
GitHub - | pyrrh1c/Start-AgentChat.ps1: Eine schlanke PowerShell-Chat-Oberfläche für jeden OpenAI-kompatiblen lokalen Inferenzserver (llama.cpp, Ollama ...
github.com/pyrrh1c/Start-AgentChat.ps1

Ich bin von LM Studio/Ollama auf llama.cpp umgestiegen und bin absolut begeistert!
xda-developers.com/switched-from-lm-studioollama-to-llamacpp-and-i-love-it/
Next