
Community-Benchmark: v0.0.3 · Issue #2 · hardenedlinux/SonicBoom: Vielen Dank für Ihre Hilfe! Dieses Issue sammelt nur Ergebnisse für v0.0.3. Es wird gesperrt ...
github.com/hardenedlinux/SonicBoom/issues/2


Ich habe eine Gemini-Alternative gefunden, die komplett offline auf meinem Handy läuft
androidpolice.com/gemini-alternative-that-runs-completely-offline-on-my-phone/


Mein lokales LLM ist klein genug, um auf meinem Laptop zu laufen, aber intelligent genug, um diese drei Abonnements zu ersetzen.
xda-developers.com/my-local-llm-is-small-enough-to-run-on-my-laptop-but-smart-enough-to-replace-these-x-subscriptions/

Ich habe eine Gemini-Alternative gefunden, die komplett offline auf meinem Handy läuft
androidpolice.com/gemini-alternative-that-runs-completely-offline-on-my-phone/
GitHub - | cannitellinicholas-spec/PixelUnlockGPU: OpenAI-kompatibler, geräteinterner LiteRT-LM-Server für Pixel (Tensor G5) – stellt Gemma für TypingMind und ...
github.com/cannitellinicholas-spec/PixelUnlockGPU

GitHub - | solvingSteve/Gevva0: Lokales System-0-Entscheidungsgateway, basierend auf Gemma 4. Direkte Logit-Bewertung, KV-Cache-Sequenzverzweigung und ...
github.com/solvingSteve/Gevva0

Gemma 4 läuft einwandfrei auf meinem Laptop, aber die Installation auf meinem NAS hat meine Nutzung verändert
xda-developers.com/gemma-4-runs-fine-on-my-laptop-but-putting-it-on-my-nas-is-what-changed-how-i-use-it/
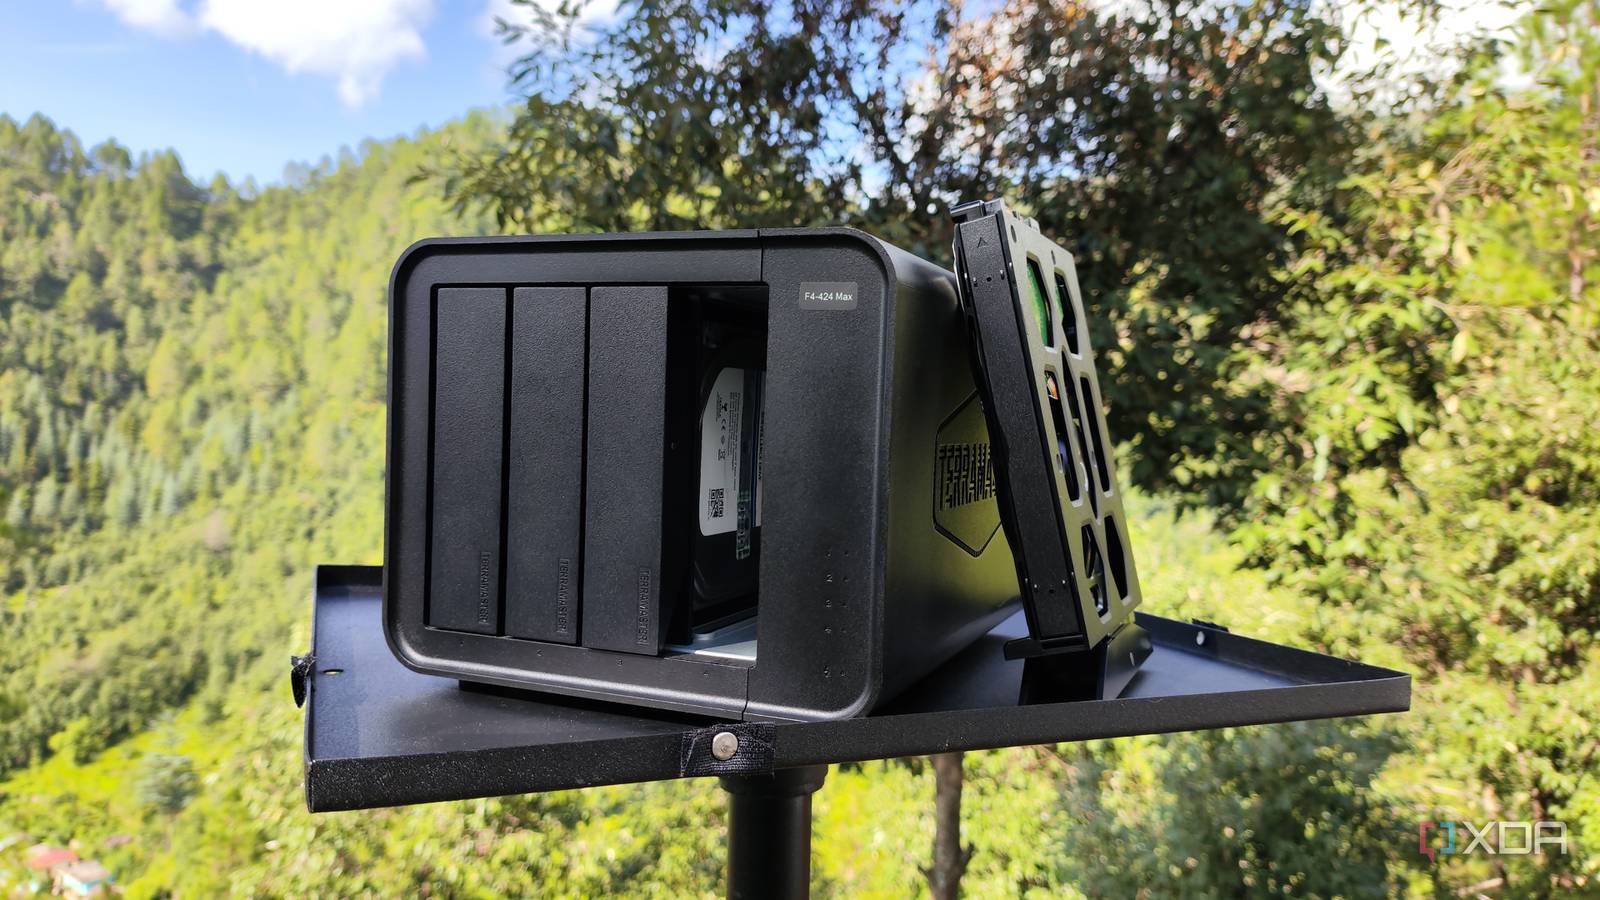
Gemma 4 läuft einwandfrei auf meinem Laptop, aber die Installation auf meinem NAS hat meine Nutzung verändert
xda-developers.com/gemma-4-runs-fine-on-my-laptop-but-putting-it-on-my-nas-is-what-changed-how-i-use-it/
Nach dem Testen von über 20 lokalen LLMs sind dies die 4, die ich für verschiedene Aufgaben installiert habe.
xda-developers.com/local-llms-i-keep-installed-for-different-jobs/
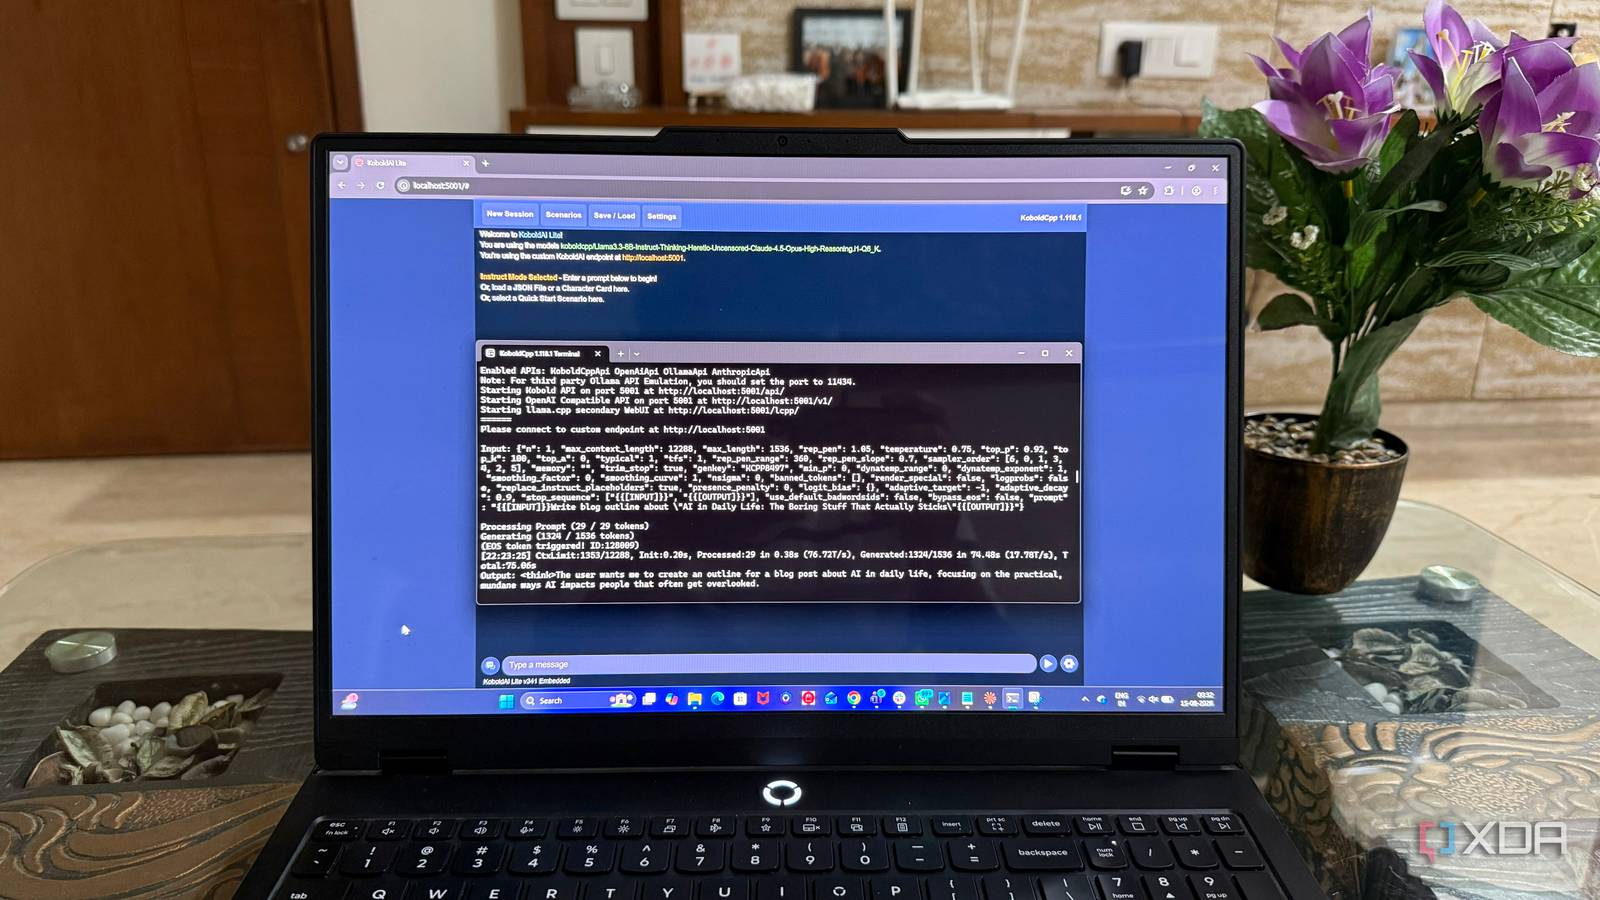
Mein lokales LLM ist klein genug, um auf meinem Laptop zu laufen, aber intelligent genug, um diese drei Abonnements zu ersetzen.
xda-developers.com/my-local-llm-is-small-enough-to-run-on-my-laptop-but-smart-enough-to-replace-these-x-subscriptions/
Diese Open-Source-Google-App verwandelte mein Handy in ein vollständig lokales KI-Labor.
xda-developers.com/this-google-app-turned-my-phone-into-fully-local-ai-lab/

GitHub - | terryguo3180-eng/Gemma.c: Gemma 1/2/3-Modellinferenz in einer einzigen C-Datei, unterstützt W8A8-Quantisierung
github.com/terryguo3180-eng/Gemma.c

Diese Open-Source-Google-App verwandelte mein Handy in ein vollständig lokales KI-Labor.
xda-developers.com/this-google-app-turned-my-phone-into-fully-local-ai-lab/
Diese Open-Source-Google-App verwandelte mein Handy in ein vollständig lokales KI-Labor.
xda-developers.com/this-google-app-turned-my-phone-into-fully-local-ai-lab/
Ich habe einen Monat lang drei lokale LLM-Apps für Mobilgeräte getestet, und die unbeliebteste kann, was die anderen nicht können.
xda-developers.com/tried-mobile-local-llm-apps-for-month-least-popular-one-does-what-the-rest-cant/

Ich habe meinen alten Windows 10 Gaming-PC als llama.cpp-Server wiederbelebt, und er ist gut genug für alltägliche Produktivitätsanwendungen.
xda-developers.com/i-revived-my-old-windows-10-gaming-pc-as-a-llamacpp-server/
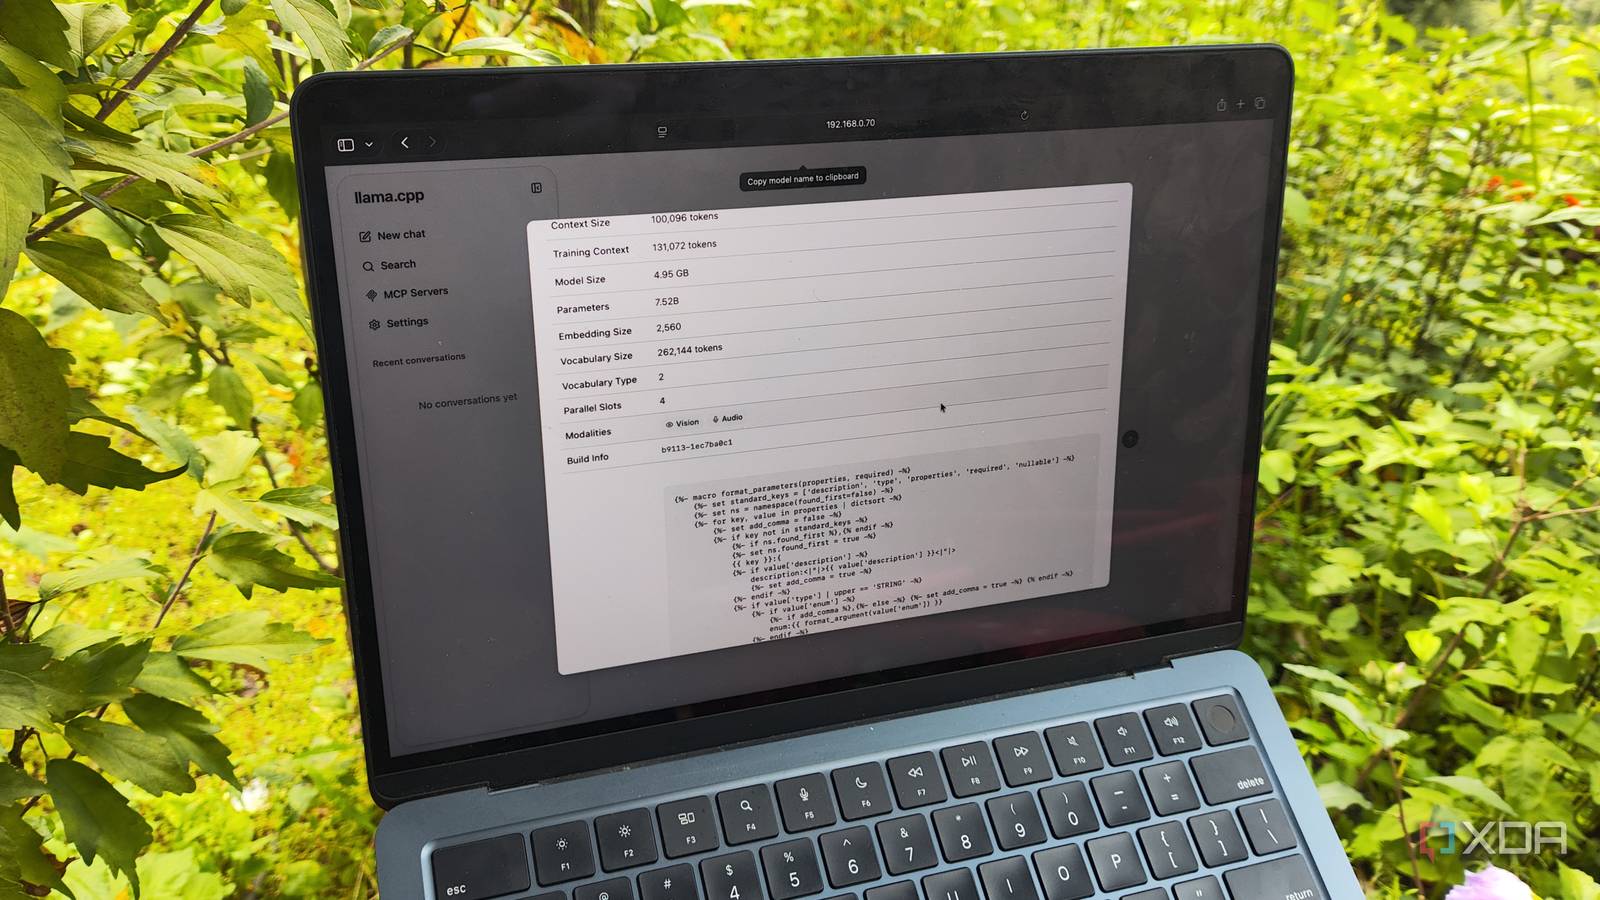
Ich habe aufgehört, Qwen und Gemma zu nutzen, nachdem ich einen lokalen LLM gefunden habe, der tatsächlich nachdenkt, bevor er antwortet.
xda-developers.com/stopped-using-qwen-and-gemma-after-finding-local-llm-that-thinks-before-answering/
GitHub - | dysangel/vllm at qwen38next-sm121: Eine leistungsstarke und speichereffiziente Inferenz- und Bereitstellungs-Engine für LLMs - | GitHub - | ...
github.com/dysangel/vllm/tree/qwen38next-sm121


4 alltägliche Dinge, die ein lokaler LLM für mich erledigt, für die ich niemals einen Chatbot bezahlen würde.
xda-developers.com/x-everyday-things-a-local-llm-does-for-me-that-i-would-never-pay-a-chatbot-for/
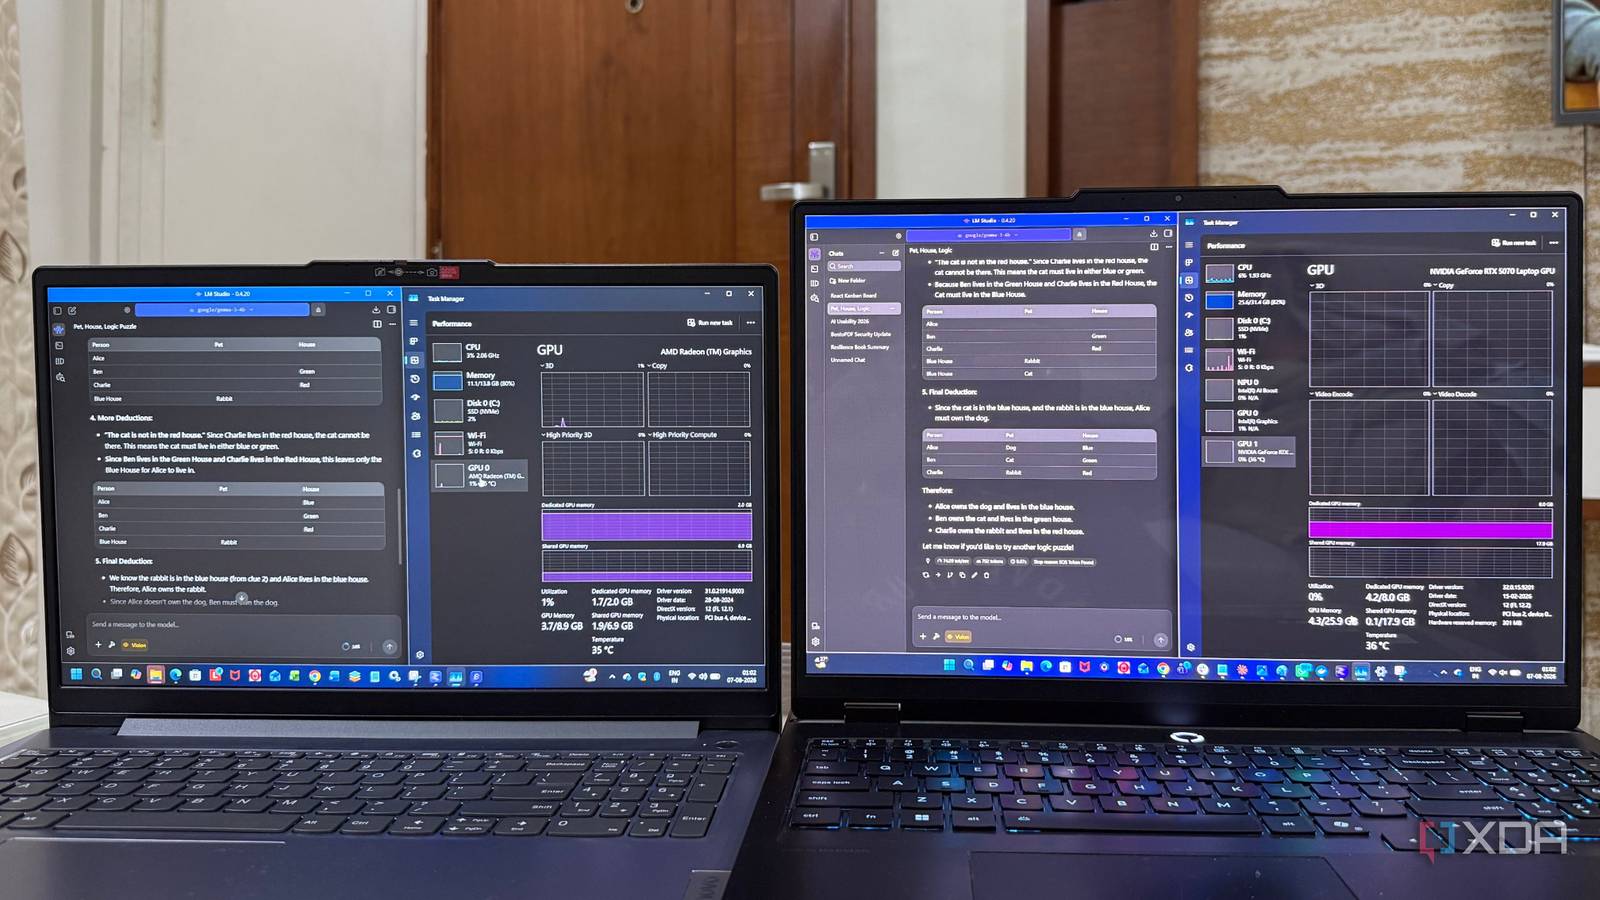
Ich habe dasselbe lokale LLM auf einer RTX 5070 und integrierter Grafik ausgeführt, und die Ergebnisse haben meine Erwartungen übertroffen.
xda-developers.com/same-local-llm-on-rtx-5070-and-integrated-graphics/

Premsys App – | App Store: Laden Sie Premsys von Premsys Inc. im App Store herunter. Sehen Sie Screenshots, Bewertungen, Nutzertipps und weitere Apps wie Premsys ...
apps.apple.com/us/app/premsys/id6791407839


Ich habe mein Smartphone mithilfe meines lokalen LLM in einen KI-Agenten verwandelt, und es hat selbstständig Software installiert.
xda-developers.com/turned-phone-ai-agent-powered-local-llm-installed-software/

Keine Cloud, keine GPUs, kein Problem: Das neue Modell LFM2.5-2.6B von Liquid AI bringt leistungsstarke KI-Agenten auf Geräte so klein wie einen Raspberry Pi
venturebeat.com/technology/no-cloud-no-gpus-no-problem-liquid-ais-new-model-lfm2-5-2-6b-brings-powerful-ai-agents-to-devices-as-small-as-a-raspberry-pi
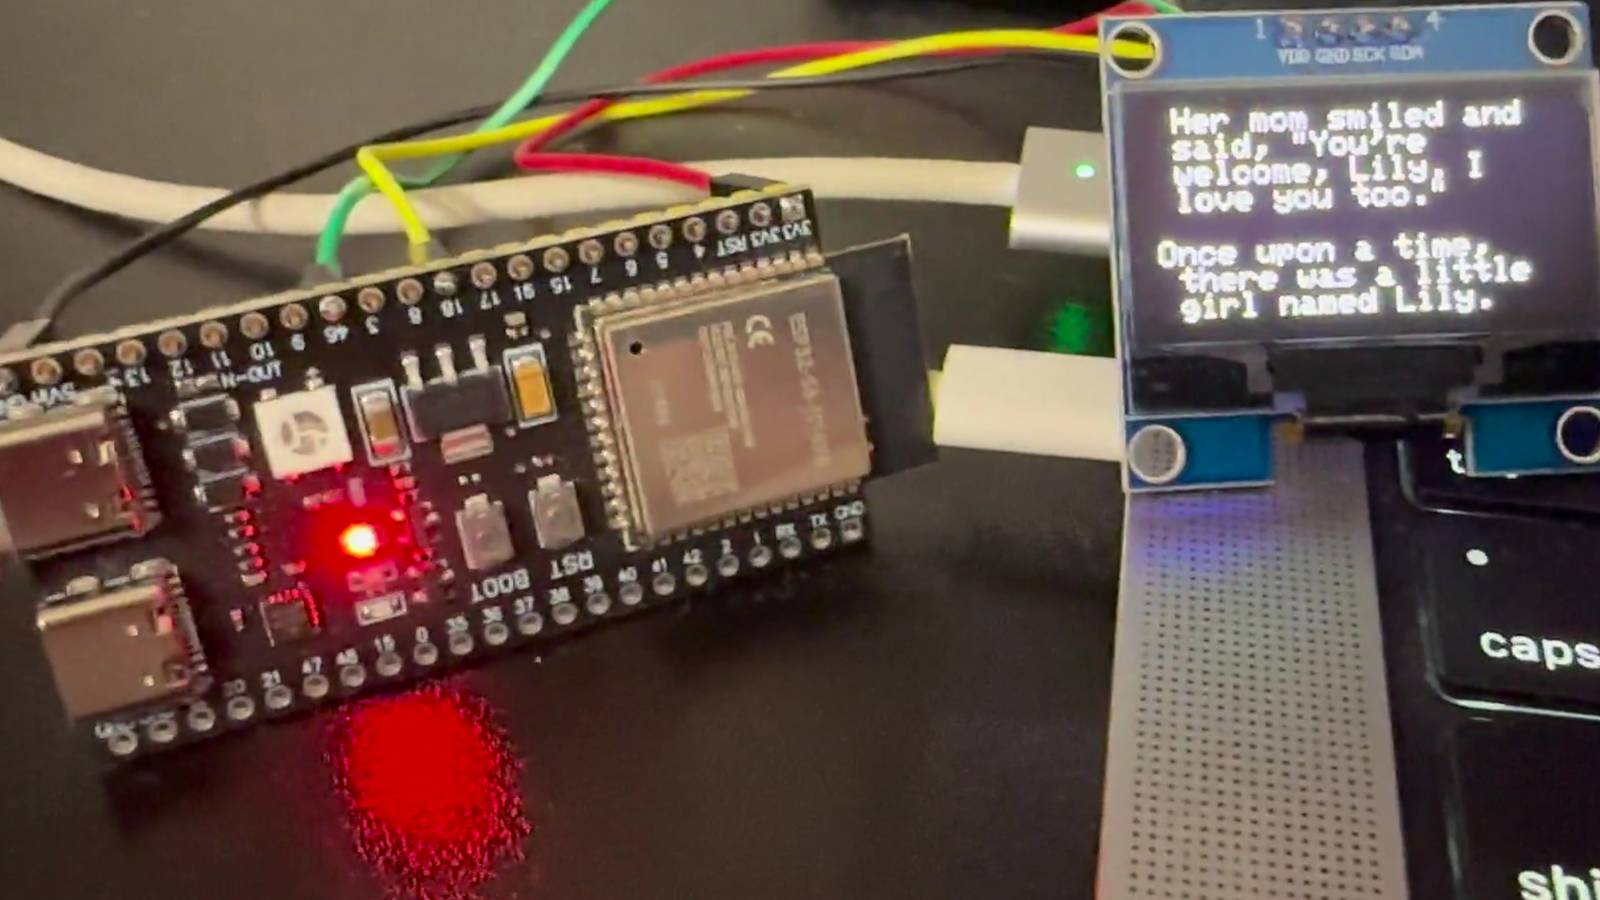
Jemand hat einen 28,9-Millionen-LLM auf einen ESP32-S3 gequetscht, und das können Sie auch.
xda-developers.com/someone-squeezed-a-289m-llm-onto-an-esp32-s3-and-so-can-you/
Meta kehrt mit Muse Glimmer, einem unter der Apache-2.0-Lizenz stehenden LLM mit 30 Milliarden Parametern, zu Open Source zurück.
venturebeat.com/technology/meta-returns-to-open-source-with-muse-glimmer-an-apache-2-0-licensed-30b-parameter-ai-model-optimized-for-agents-available-now
Ich habe jedes kleine lokale LLM getestet, das es wert ist, ausgeführt zu werden, und nur drei haben die Prüfung bestanden.
xda-developers.com/tested-every-tiny-local-llm-worth-running-only-these-survived-the-cut/
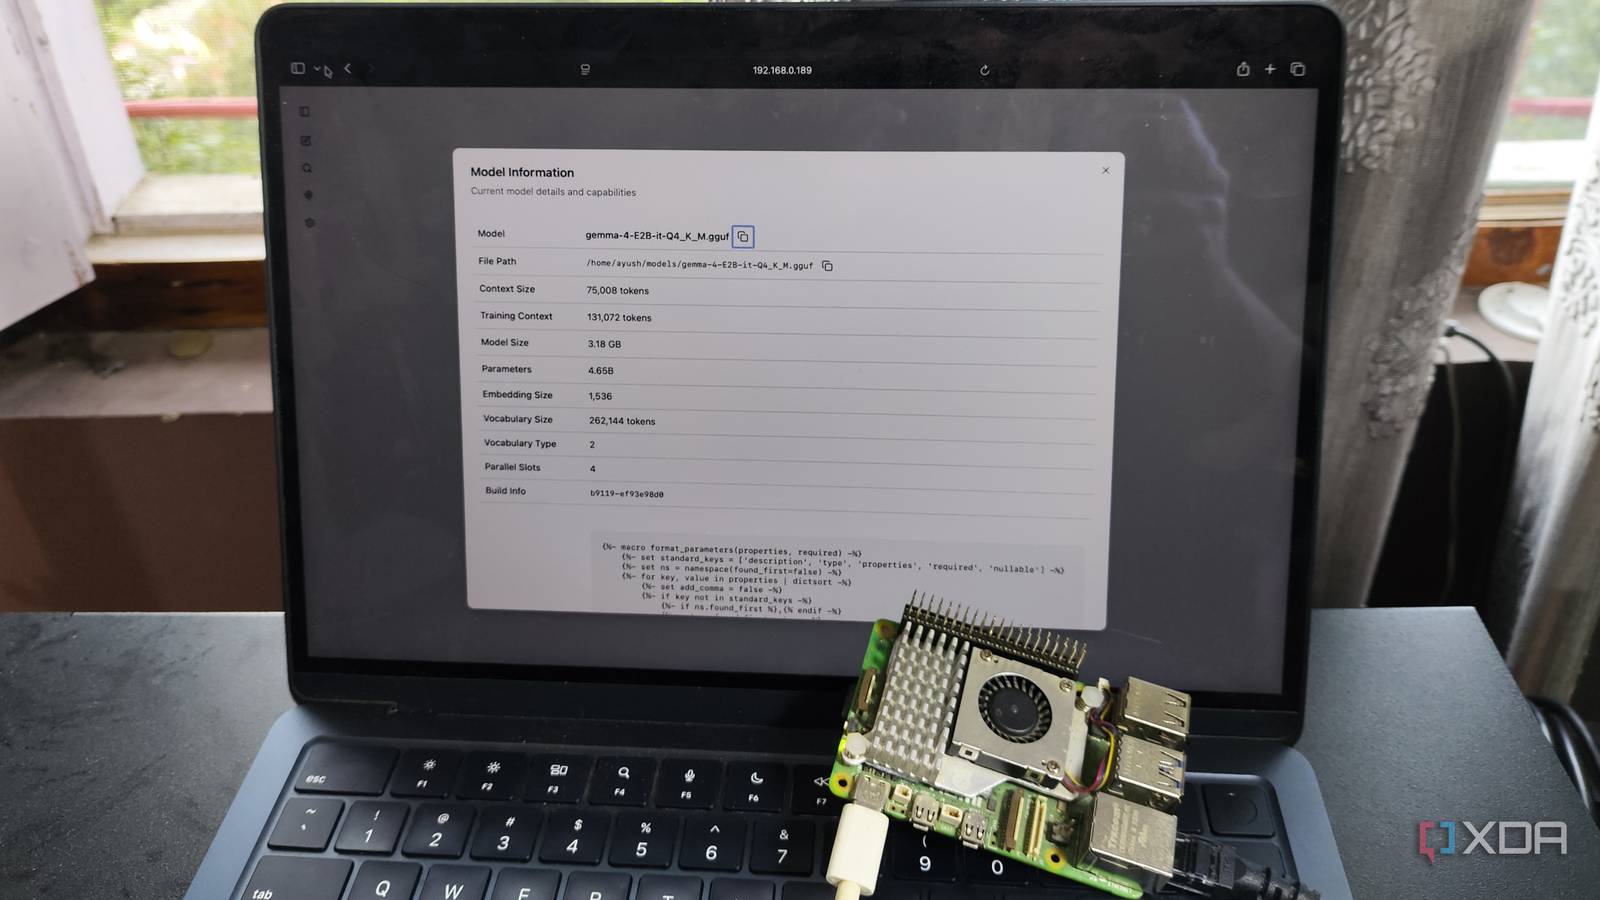
Gemma 4 E2B beweist, dass LLMs in Raspberry-Pi-Größe nicht mehr schlecht sein müssen.
xda-developers.com/gemma-4-e2b-proves-raspberry-pi-llms-dont-have-to-be-terrible/
GitHub - | nathanlgabriel/local_LLM_transitive_inf_assessment: Testen einiger lokaler Modelle auf ihre Fähigkeit, schlecht geschriebenen Modellcode aus einem ...
github.com/nathanlgabriel/local_LLM_transitive_inf_assessment


Chinesische Fake-Models geben sich als Claude aus: Forscher finden heraus, dass GLM und Kimi Claudes Identität annehmen können, aber die Beweise reichen nicht ...
theregister.com/ai-and-ml/2026/07/27/impostor-chinese-models-pretend-theyre-claude/5279165
GitHub - | drumih/turbo-fieldfare: Gemma 4 26B-A4B Inferenz mit ~2 GB RAM auf jedem MacBook der M-Serie
github.com/drumih/turbo-fieldfare

GitHub - | jscott3201/hyperion: M5-erste lokale Gemma-4-Inferenz in Rust + MLX.: M5-erste lokale Gemma-4-Inferenz in Rust + MLX. Beteilige dich an der ...
github.com/jscott3201/hyperion

Jemand hat einen 28,9-Millionen-LLM auf einen ESP32-S3 gequetscht, und das können Sie auch.
xda-developers.com/someone-squeezed-a-289m-llm-onto-an-esp32-s3-and-so-can-you/

KI-Entwickler führt 28,9-Millionen-Parameter-Modell auf einem 10-Dollar-Mikrocontroller ESP32-S3 aus – nutzt Googles Per-Layer-Embeddings-Technik und speichert ...
tomshardware.com/tech-industry/artificial-intelligence/ai-developer-runs-28-9-million-parameter-model-on-usd10-esp32-s3-microcontroller-uses-googles-per-layer-embeddings-technique-stores-table-on-16mb-flash-memory

Jemand hat einen 28,9-Millionen-LLM auf einen ESP32-S3 gequetscht, und das können Sie auch.
xda-developers.com/someone-squeezed-a-289m-llm-onto-an-esp32-s3-and-so-can-you/

Kleine Sprachmodelle ermöglichen lebensrettende kleine KI: An Orten mit unzuverlässigen Netzwerken und ohne Rechenzentrumsinfrastruktur ist kleiner besser
spectrum.ieee.org/small-language-models-ai-pharmaceuticals

NASA nutzt KI zur Analyse von Satellitenbildern im Orbit: Gemma 3 läuft auf Nvidia-Hardware zur Analyse von Satellitenbildern
spectrum.ieee.org/nasa-ai-satellite-image-analysis
Google kündigt Gemma 4 für die TPU des Pixel 10 optimiert an: Google hat heute Gemma 4 E2B für TPU angekündigt, das nativ auf der TPU des Pixel 10 läuft ...
9to5google.com/2026/07/14/pixel-10-gemma-4/

Gemma 4 sieht, hört und liest auf meinem 16-GB-Laptop und telefoniert nie nach Hause.
xda-developers.com/gemma-4-sees-hears-and-reads-on-my-16gb-laptop-and-it-never-phones-home/
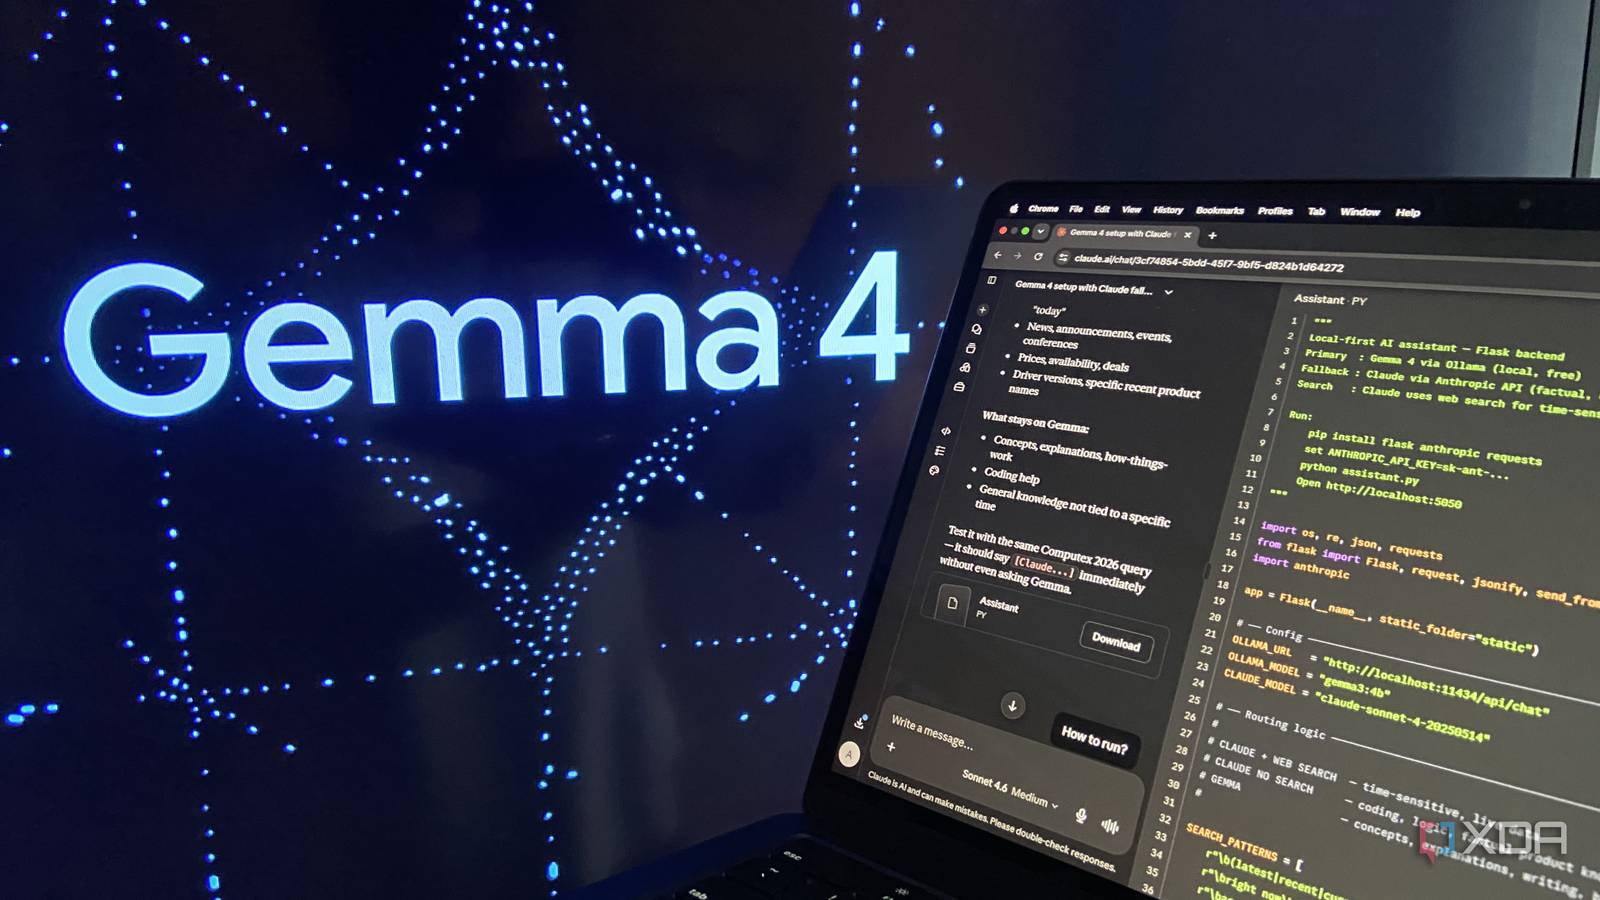
GitHub - | jegly/Box: Die fortschrittlichste, vollständig offline nutzbare Client-seitige KI-Suite für Android.
github.com/jegly/Box

Lokale LLMs schlagen Cloud-KI endlich bei Programmierung, Automatisierung und Brainstorming – hier sind die, die ich verwende
xda-developers.com/local-llms-finally-beat-cloud-ai-for-coding-automation-and-brainstorming-heres-which-ones-i-use/

Googles neueste KI-Offensive für Pixel sorgt dafür, dass Ihre Daten auf Ihrem Smartphone bleiben
androidauthority.com/google-gemma-4-e2b-for-tpu-unveiled-3687531/
Kleine Sprachmodelle ermöglichen lebensrettende kleine KI: An Orten mit unzuverlässigen Netzwerken und ohne Rechenzentrumsinfrastruktur ist kleiner besser
spectrum.ieee.org/small-language-models-ai-pharmaceuticals
KurzfaktenKleine KI revolutioniert globale Gesundheitsversorgung
07.07.2026 · Lesezeit: ~45 Sek.
Zusammenfassung mit KI-Unterstützung · Quelle: spectrum.ieee.org
Zusammenfassung mit KI-Unterstützung · Quelle: spectrum.ieee.org
- Das RxScanner-Gerät nutzt ein kompaktes KI-Modell zur Erkennung gefälschter Medikamente direkt auf Smartphones ohne Internet.
- Kleine KI benötigt wenig Energie und läuft auf erschwinglicher Hardware wie Arduino oder Smartphones mit speziellen Chips.
- Weltweit unterstützen Organisationen wie die Weltbank Programme, um kleinen KI-Lösungen in Entwicklungsländern zum Durchbruch zu verhelfen.
- Trotz Vorteilen erfordert kleine KI eine nachhaltige Infrastruktur und regelmäßige Updates, um langfristig wirksam zu bleiben.
Wenn niemand es subventioniert, werden sich die meisten Menschen diese Modelle nicht leisten können. Also gehören diejenigen von uns, die als Small-AI-Entwickler gelten, zu denen, die für die Mehrheit der Welt bauen müssen,— Adebayo Alonge, über die Erschwinglichkeit von Small-AI-Modellen und die Notwendigkeit, sie weltweit zugänglich zu machen
Ich habe eine Woche lang versucht, die Cloud-KI meines Handys durch ein lokales Modell zu ersetzen, und das habe ich dafür aufgegeben.
xda-developers.com/tried-replacing-cloud-ai-with-local-model-what-i-gave-up/
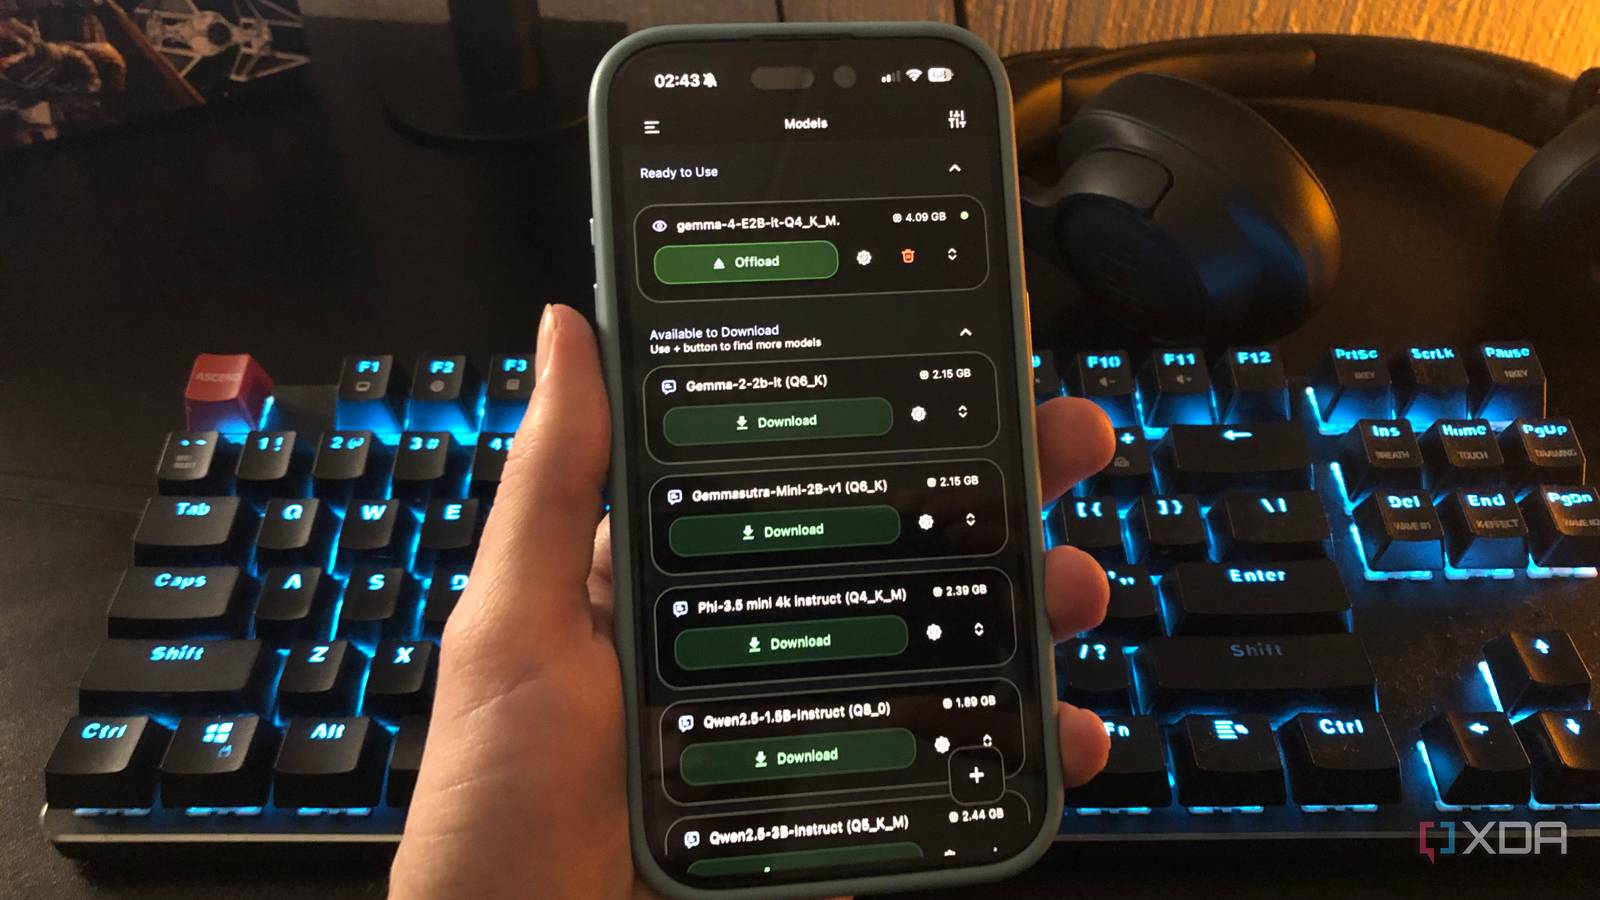
Ich habe Gemma 4 durch ein zwei Jahre altes Programmier-LLM ersetzt, und meine lokale KI-Umgebung funktioniert besser denn je.
xda-developers.com/replaced-gemma-4-with-two-year-old-coding-llm-for-non-coding-work/
Ich habe aufgehört, den größten lokalen LLM zu betreiben, der hineinpasste, und ein 2B-Modell deckt 90 % meiner Bedürfnisse ab.
xda-developers.com/stopped-running-biggest-local-llm-that-could-fit-2b-model-handles-90-percent-what-i-need/
Ich hätte fast meine GPU aufgerüstet, um größere lokale LLMs ausführen zu können, aber dieses 8B-Modell hat mir gezeigt, dass das gar nicht nötig war
xda-developers.com/almost-upgraded-gpu-to-run-larger-local-llms-but-8b-model-proved-i-didnt-have-to/
GitHub - | jscott3201/Helios: Beteiligen Sie sich an der Entwicklung von jscott3201/Helios, indem Sie ein Konto auf GitHub erstellen.
github.com/jscott3201/Helios

Gemma4-Layer-Skalar-Fix von kallewoof · Pull Request #4 · dnhkng/RYS: Beteilige dich an der Entwicklung von dnhkng/RYS, indem du ein Konto auf GitHub erstellst.
github.com/dnhkng/RYS/pull/4

Das kleinste Modell von Gemma 4 läuft mit 3 GB VRAM, und genau das ist das Modell, nach dem ich tatsächlich greife.
xda-developers.com/gemma-4-smallest-model-runs-on-3gb-vram-its-the-one-i-actually-reach-for/
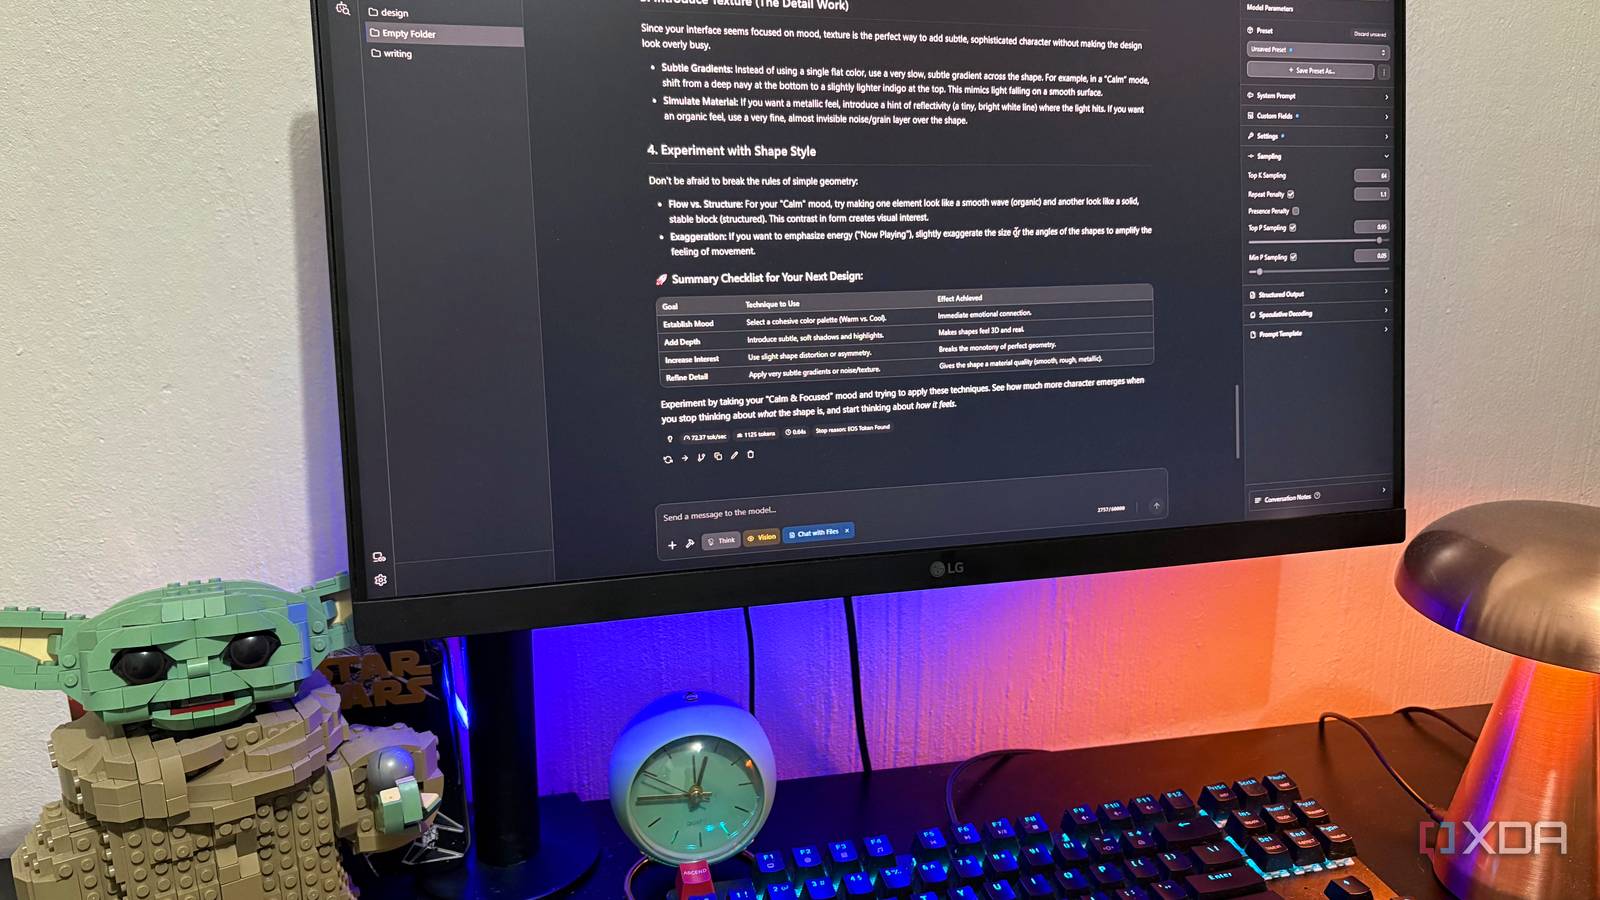
Das bisher kleinste Modell von Liquid AI, LFM2.5-230M, übertrifft Modelle, die viermal so groß sind, bei der Datenextraktion und kann überall ausgeführt werden ...
venturebeat.com/technology/liquid-ais-smallest-model-yet-lfm2-5-230m-beats-models-4x-its-size-at-data-extraction-can-run-anywhere
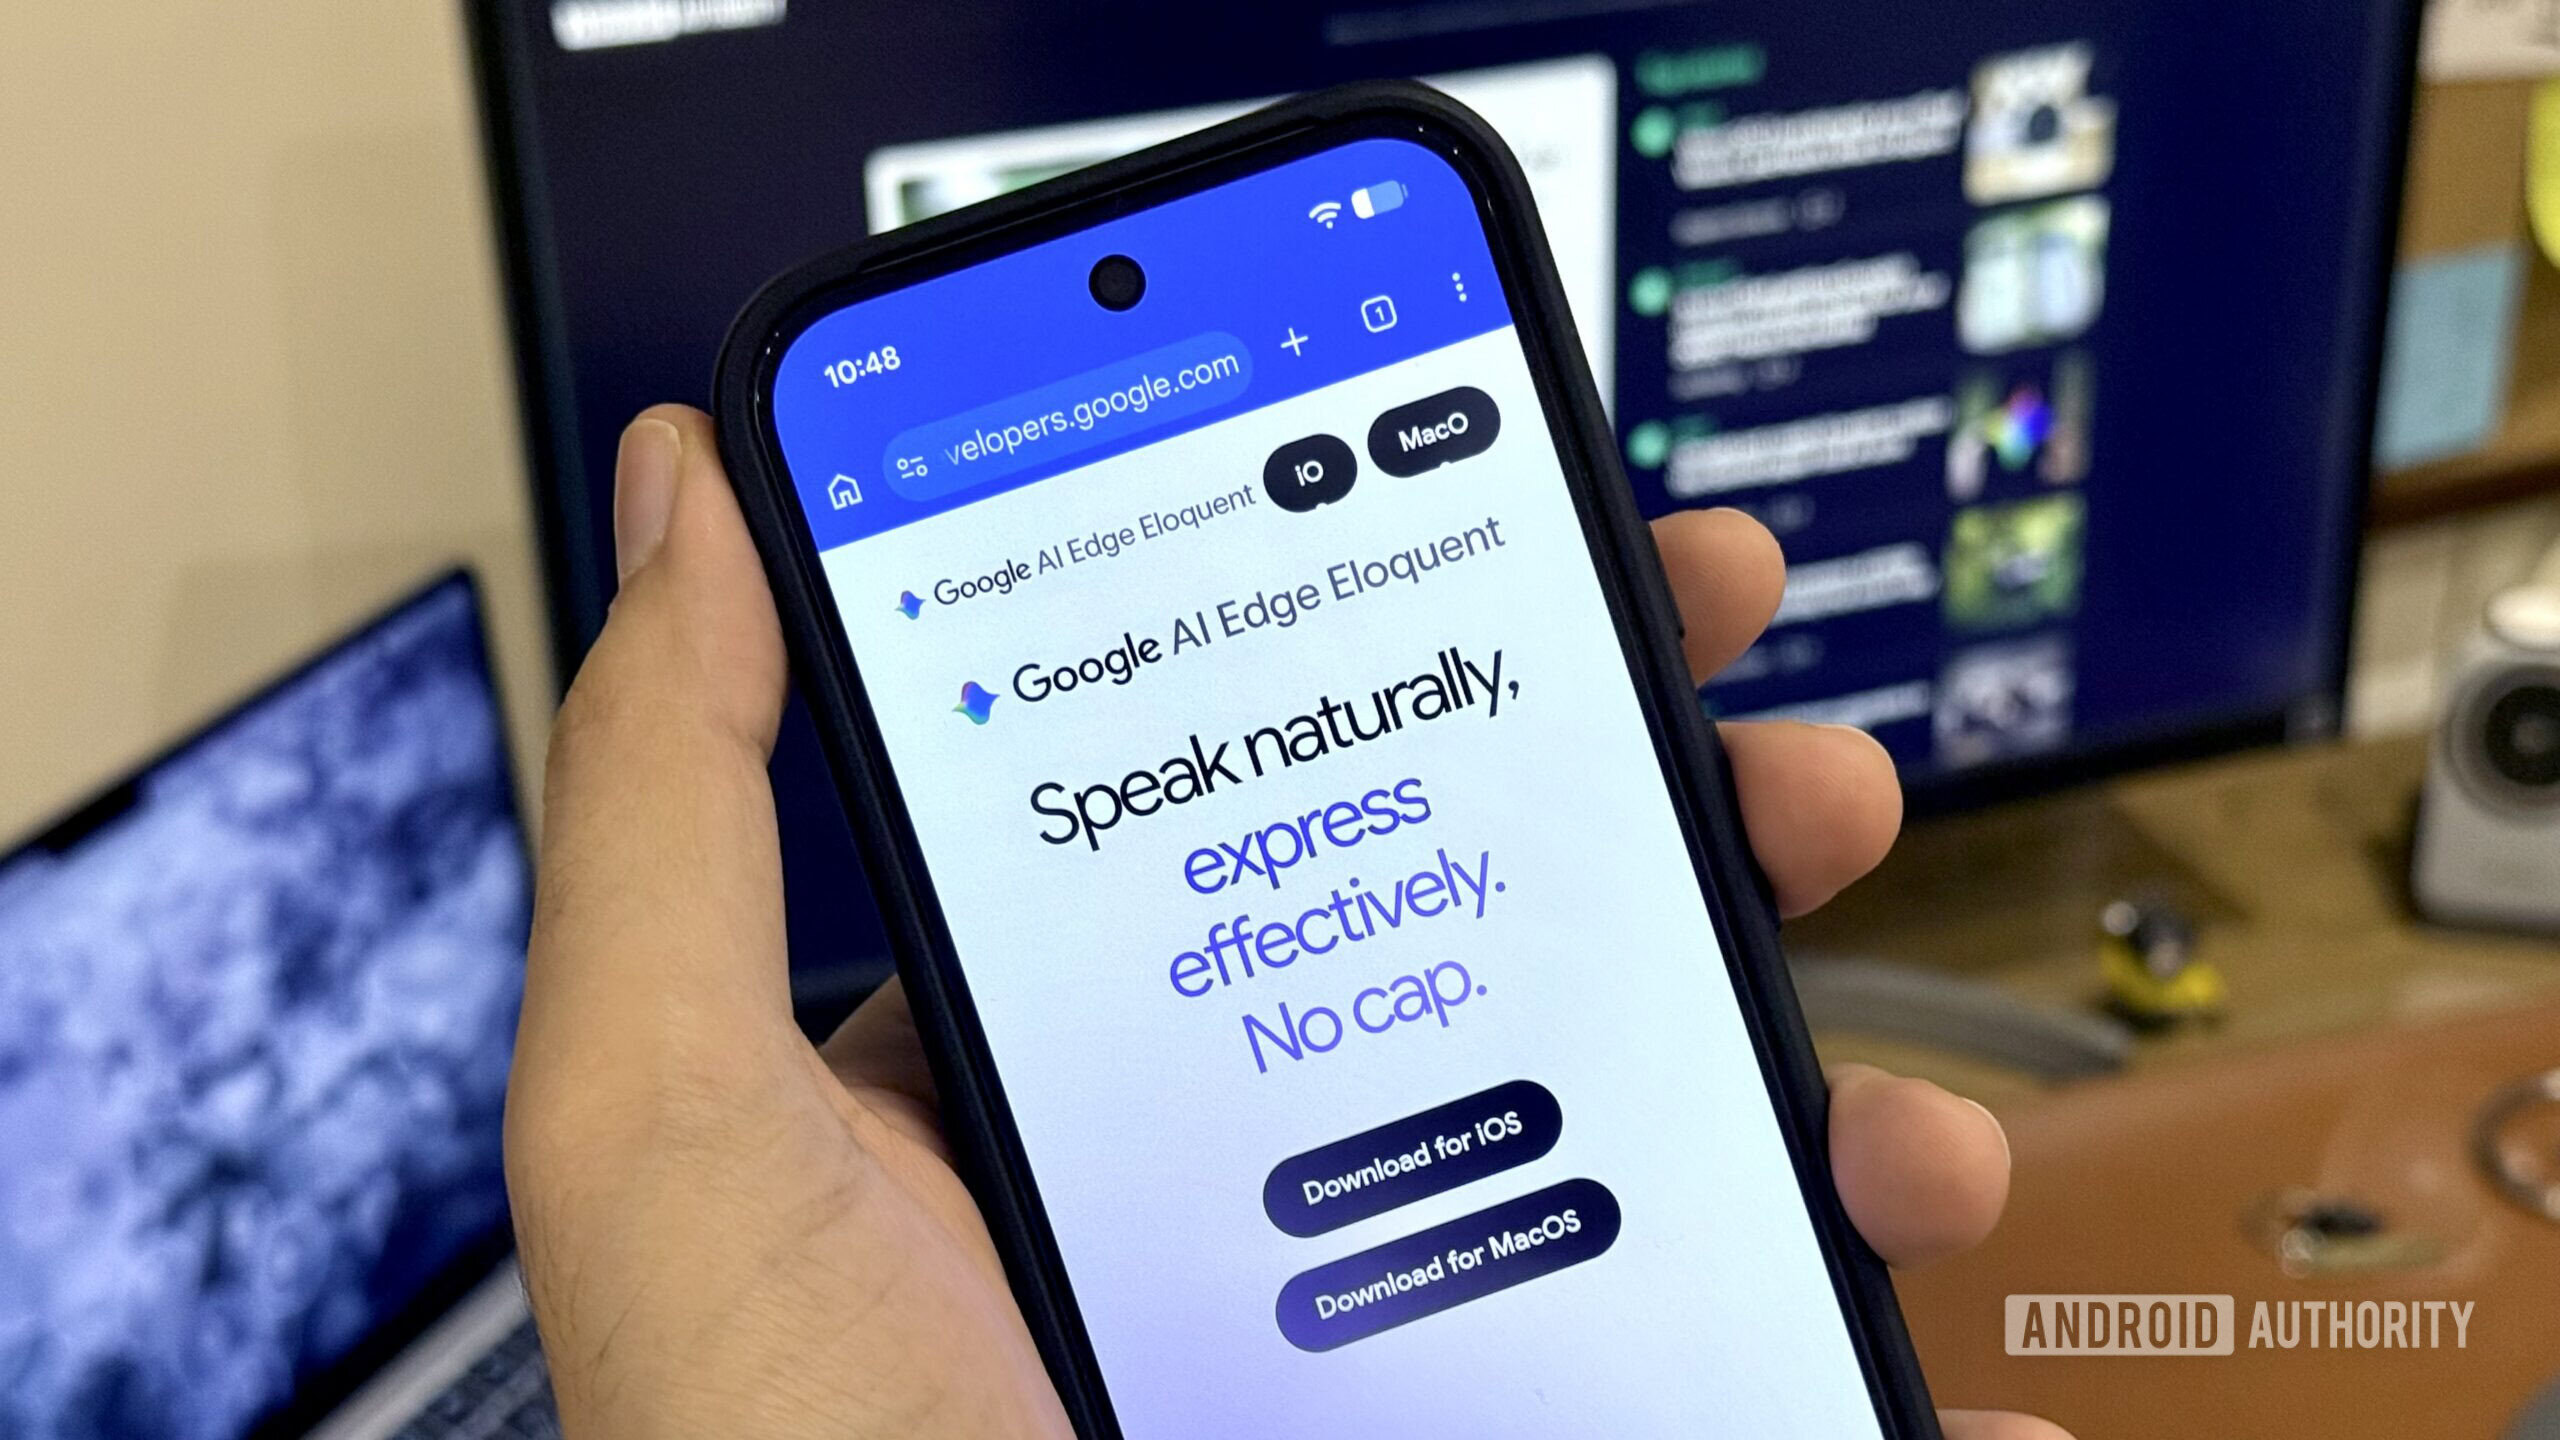
Ich wollte, dass Googles geheime KI-Diktier-App Wispr Flow ersetzt, aber das war nicht möglich.
androidauthority.com/google-ai-edge-eloquent-vs-wispr-flow-3678620/
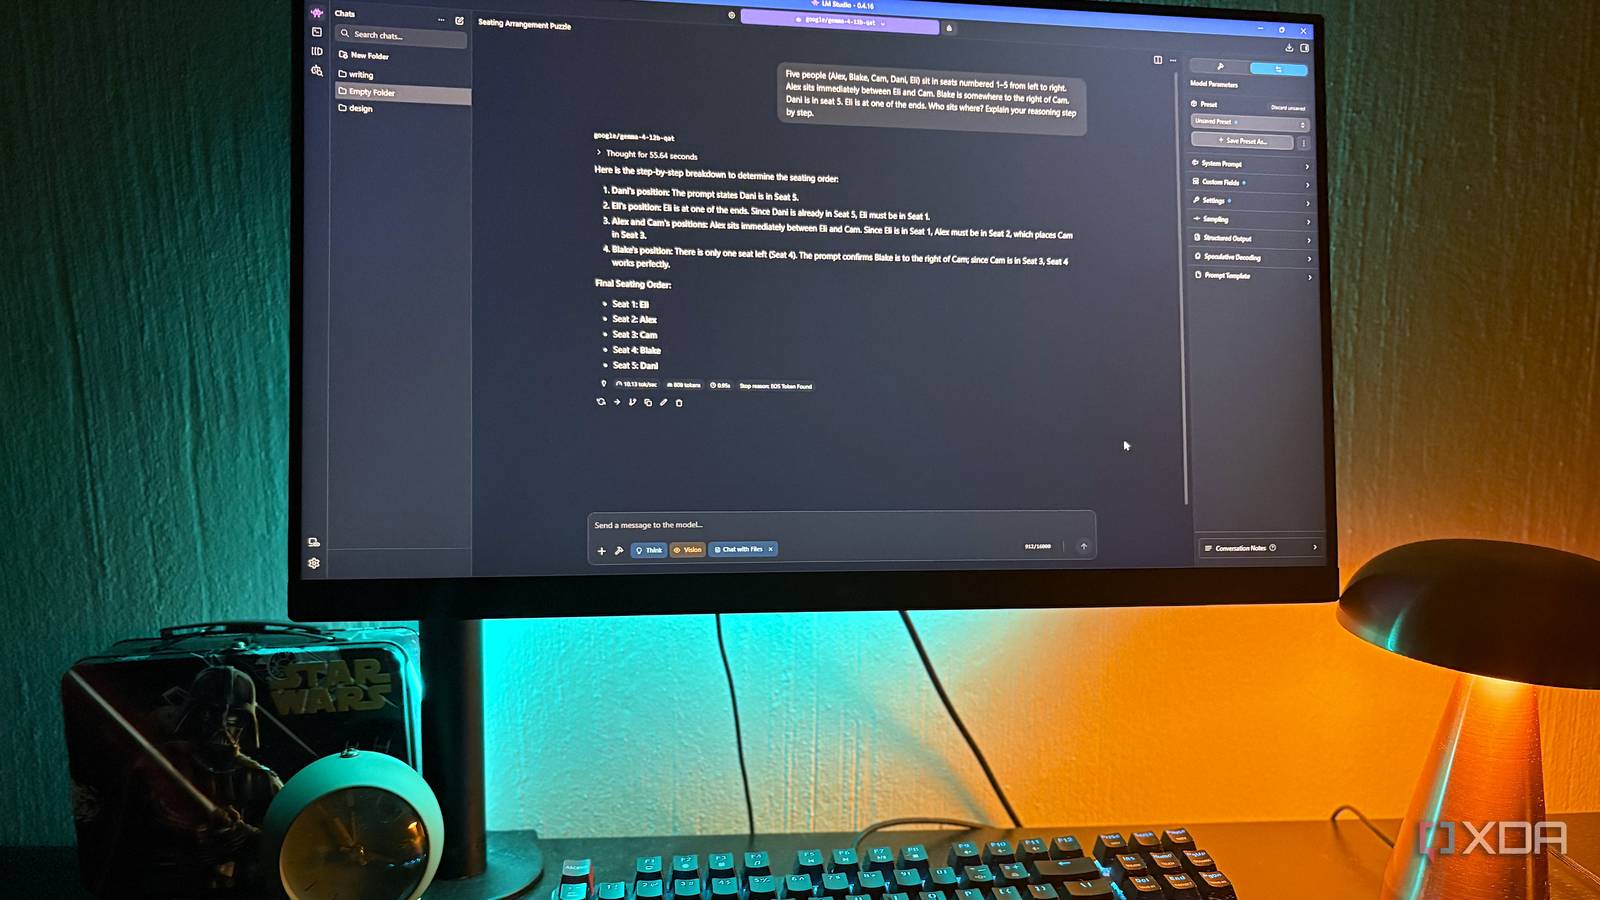
Ich habe Googles neue Gemma 4 12B auf meiner 8-GB-GPU getestet und möchte jetzt nicht mehr zu kleineren Modellen zurückkehren.
xda-developers.com/tested-google-gemma-4-12b-on-8gb-gpu-and-dont-want-to-go-back-to-smaller-models/
Ich habe Meta Llama 4, Qwen 3-Coder und Gemma 4 zur Entwicklung einer Python-App verwendet, und nur ein Modell ist für Entwickler wirklich empfehlenswert.
xda-developers.com/i-used-meta-llama-4-qwen-3-and-gemma-4-to-develop-a-python-app-and-only-one-model-is-worth-keeping-for-developers/
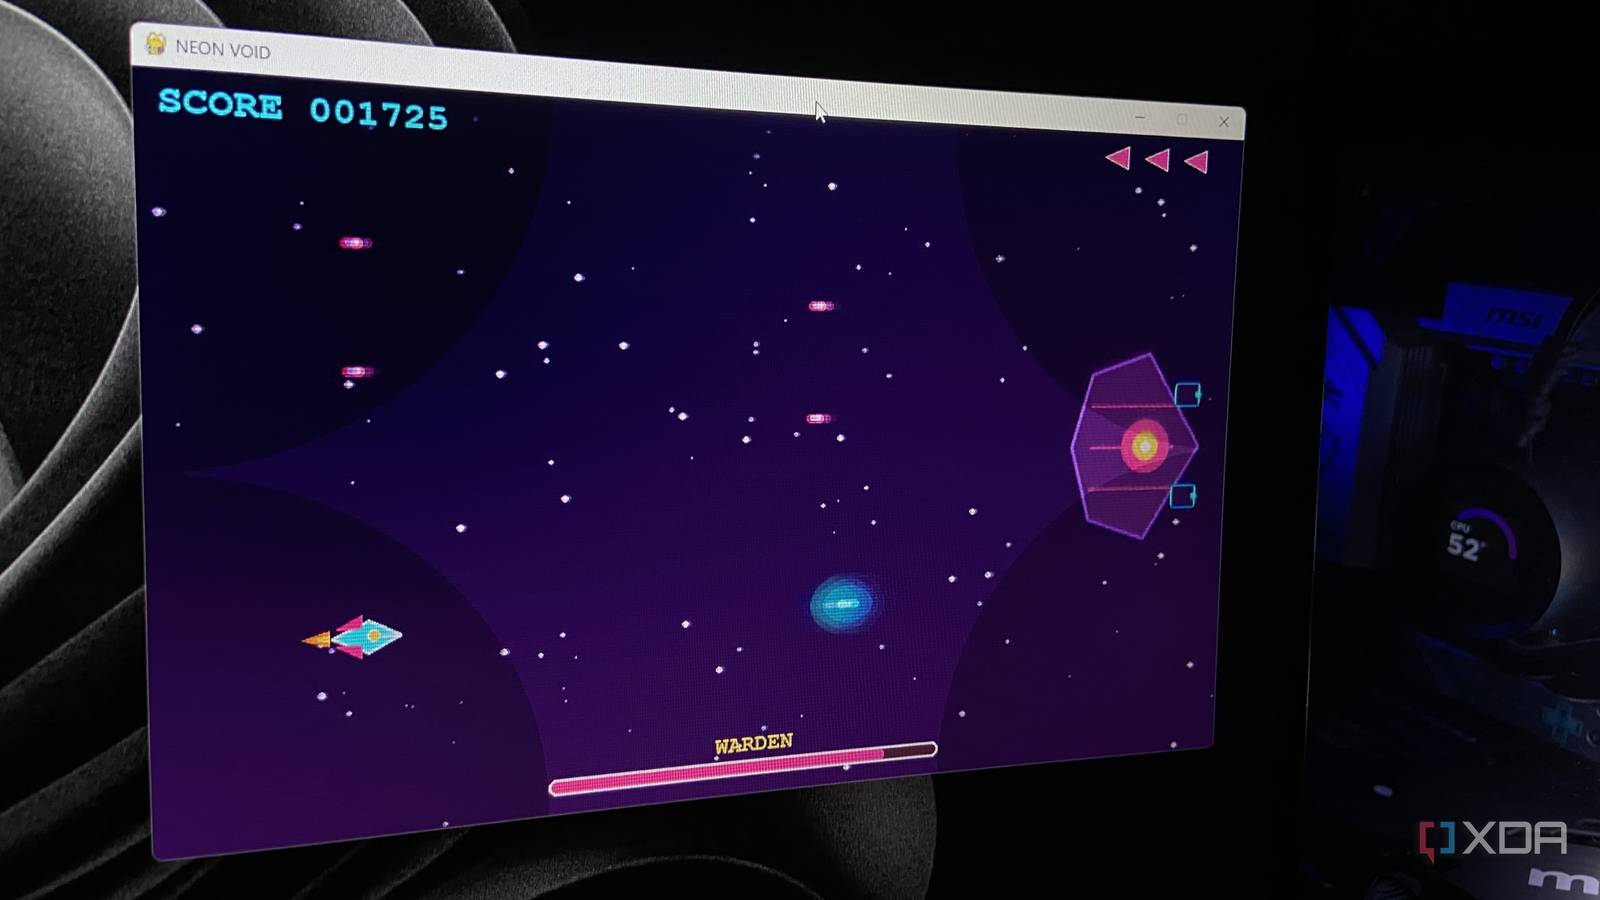
Googles DiffusionGemma verarbeitet Texte viermal schneller.: Googles Open-Source-Sprachmodell zur Diffusion generiert 256 Tokens parallel und korrigiert sich ...
venturebeat.com/technology/googles-diffusiongemma-generates-256-tokens-in-parallel-and-self-corrects-as-it-goes
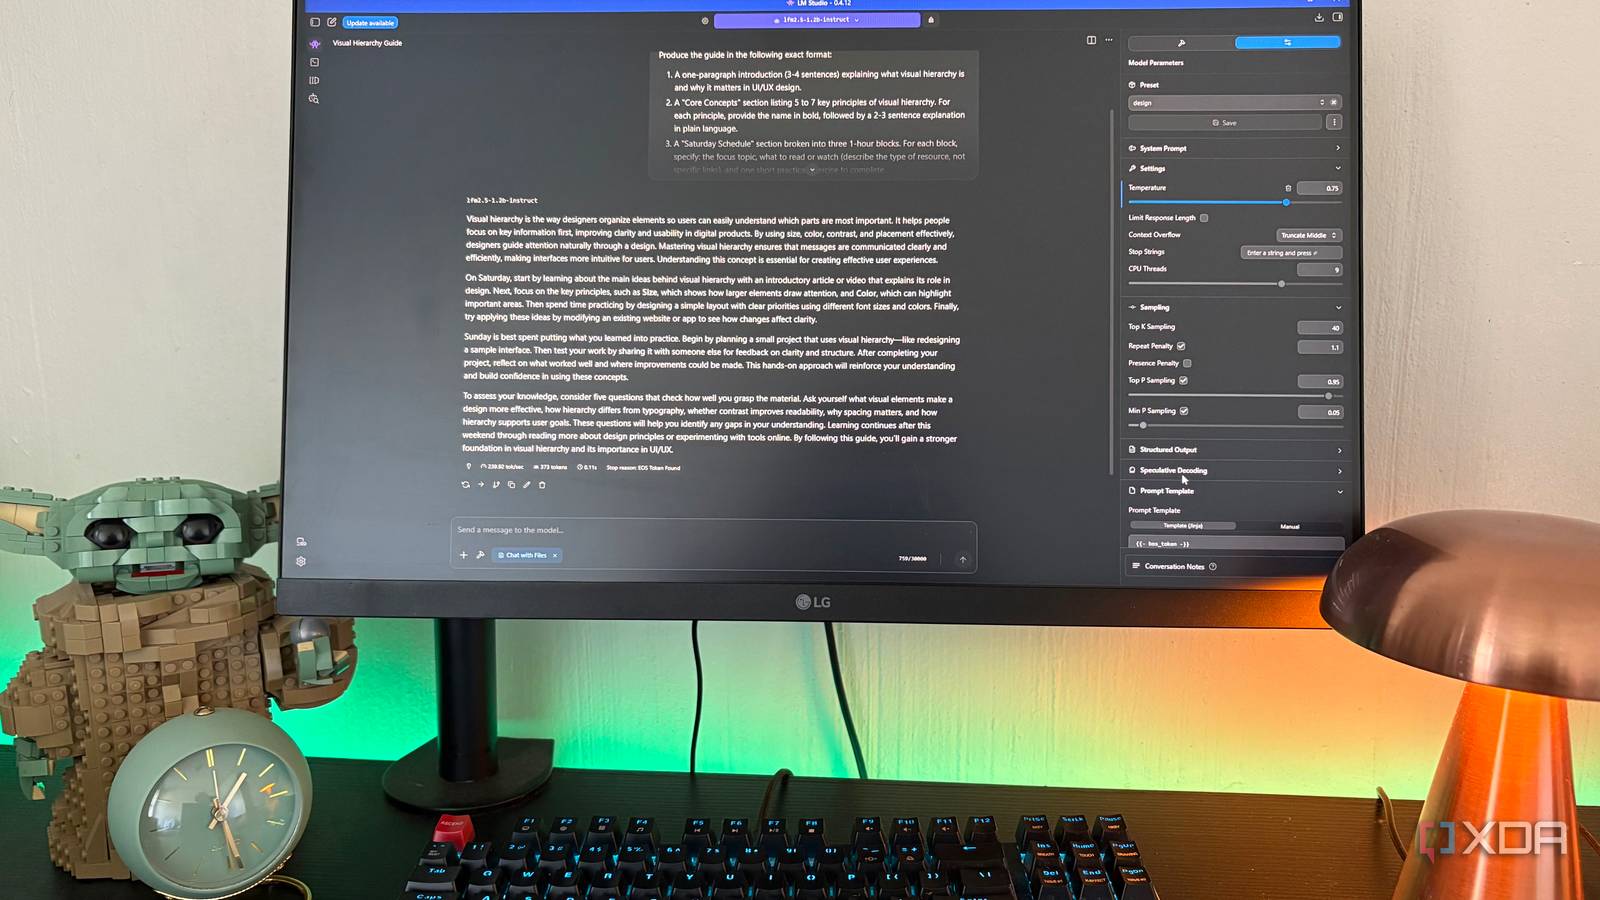
Ich habe drei lokale LLMs für UI-Design getestet, und nur einer von ihnen verhielt sich wie ein echter Designer
xda-developers.com/tested-local-llms-for-ui-design-work-only-one-behaved-like-real-designer/
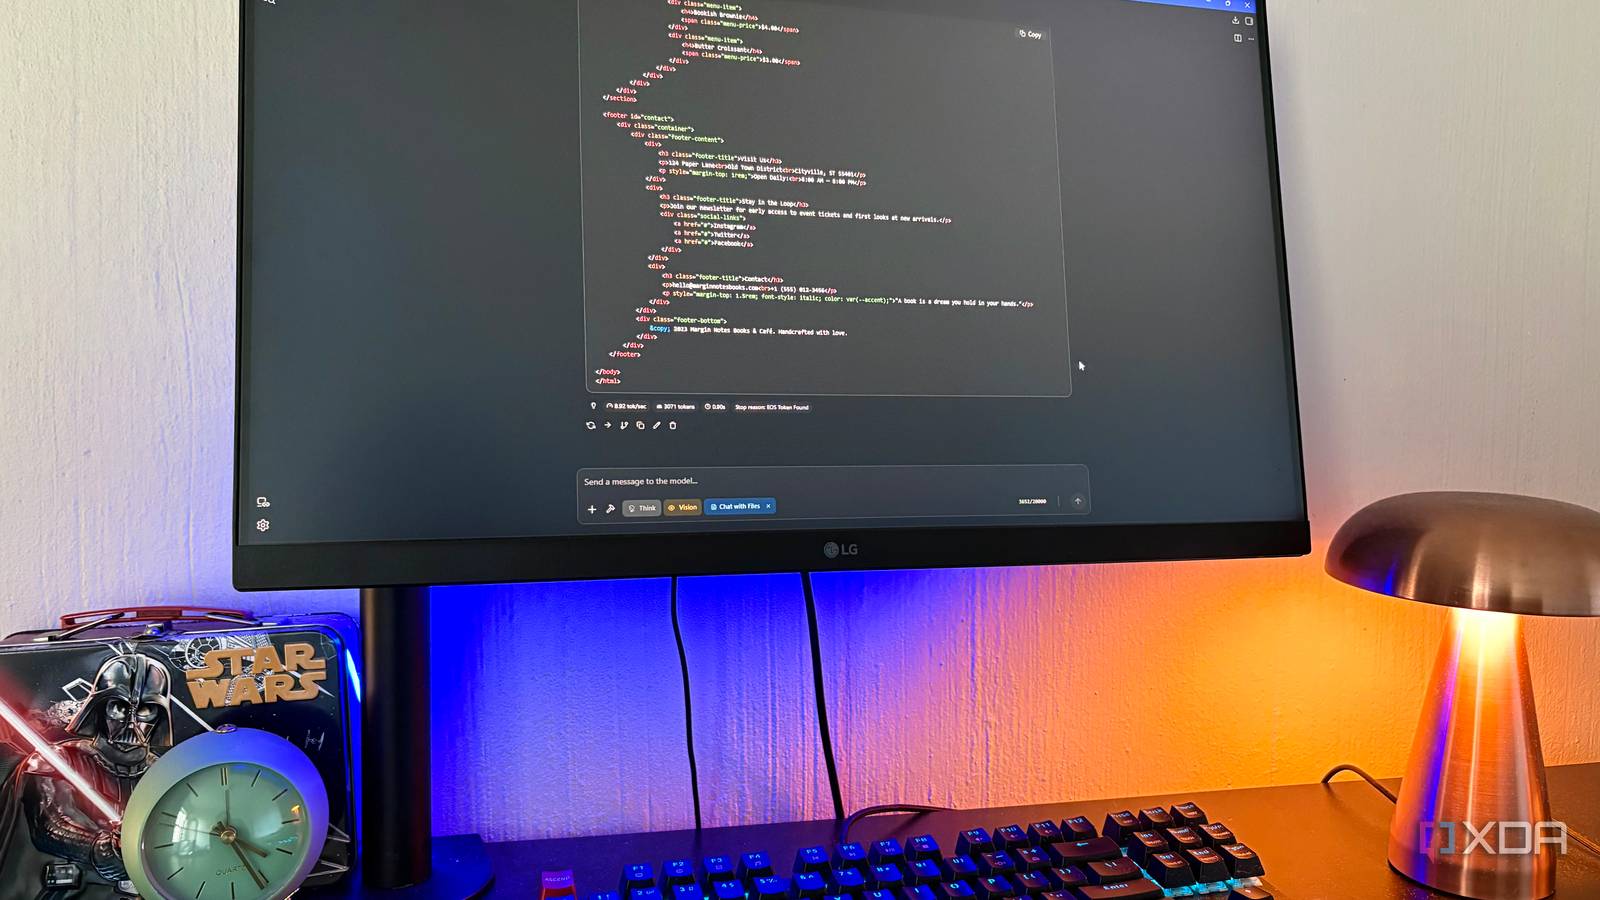
Ich habe Gemmas größtes Problem gelöst, indem ich es über Claude geleitet habe, und alles, was ich dafür brauchte, war ein Python-Skript.
xda-developers.com/i-solved-gemma-4s-biggest-problem-by-asking-it-to-call-claude-and-all-it-took-was-a-python-script/
Ich habe drei kleine lokale LLMs für den täglichen Gebrauch getestet, und nur einer davon hat mich beeindruckt
xda-developers.com/tested-tiny-local-llms-for-everyday-work-only-one-impressed-me/
GitHub - | mikechambers84/ik_llama.cpp at numa-mirror: Fork von ik_llama.cpp mit experimenteller NUMA-basierter Spiegelung der Modellgewichte pro Knoten und ...
github.com/mikechambers84/ik_llama.cpp/tree/numa-mirror
Ich habe mein lokales LLM mit 4 verschiedenen Tools getestet, und nur eines hat sein volles Potenzial ausgeschöpft.
xda-developers.com/tested-local-llm-different-tools-and-only-one-unleashed-its-potential/

Googles kostenloses Gemma 4-Modell läuft auf Hardware, die Sie wahrscheinlich schon besitzen.
xda-developers.com/googles-free-gemma-4-model-runs-on-hardware-you-probably-already-own/
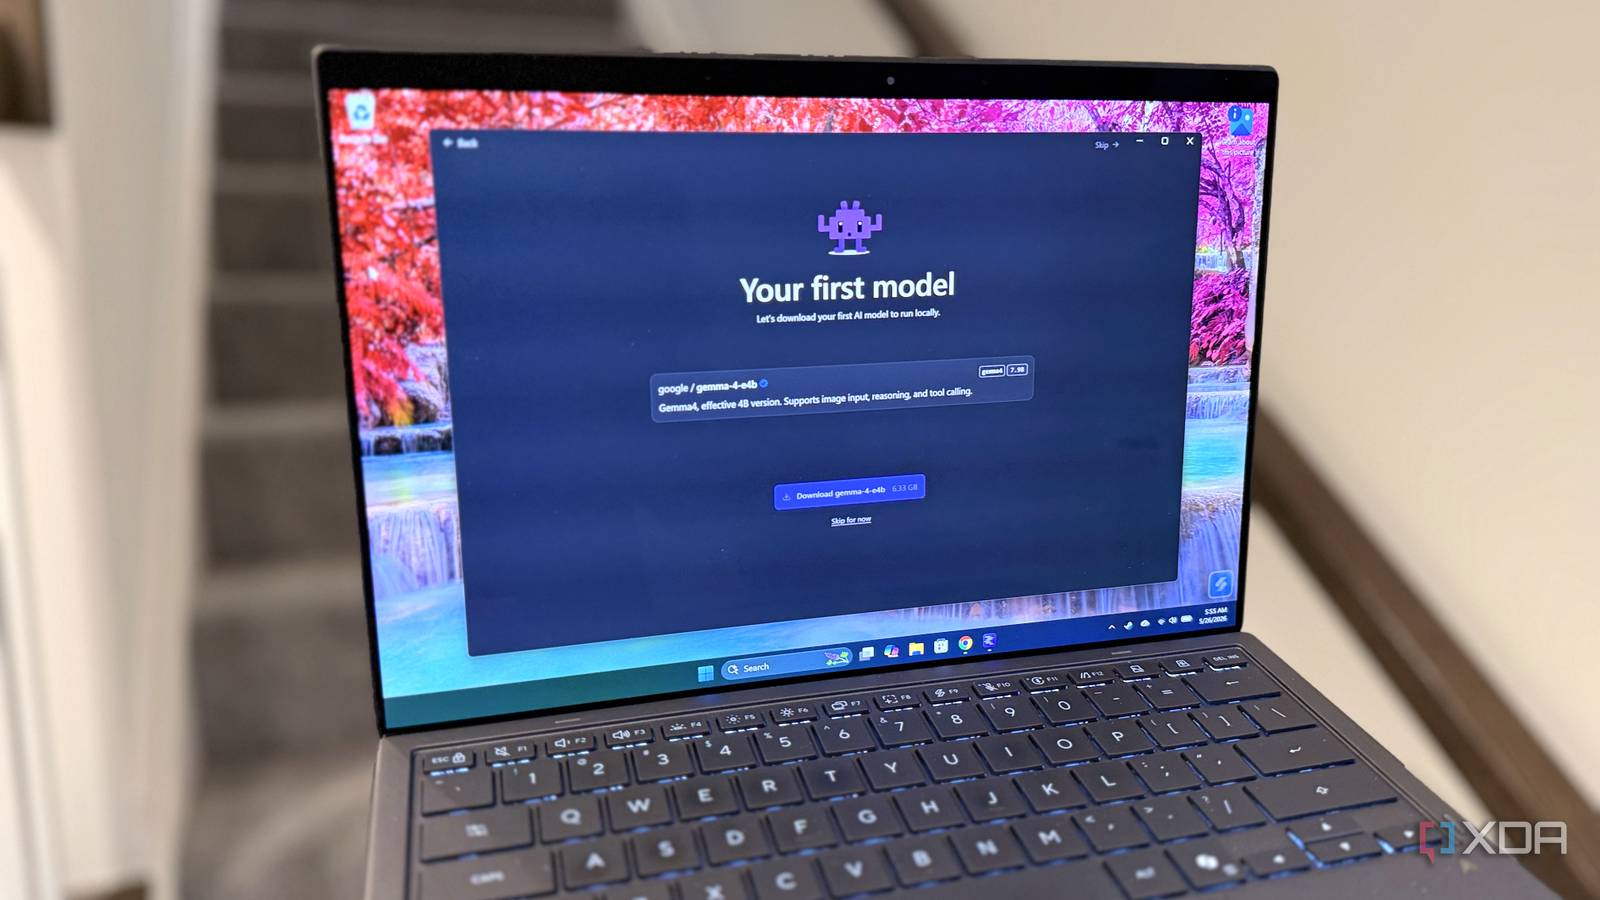
Ich habe Gemma, Llama und Qwen auf meinem Handy laufen lassen, und nur eine davon ist den Speicherplatz wert.
xda-developers.com/ran-gemma-llama-qwen-on-phone-only-one-is-worth-the-storage/

Ein Satellit findet selbstständig Objekte – was das bedeutet: Im April fand ein Erdbeobachtungssatellit zum ersten Mal überhaupt selbstständig, wonach er suchte.
techcrunch.com/2026/06/15/a-satellite-just-learned-to-find-things-on-its-own-heres-what-that-means/

I replaced ChatGPT, Claude, and Gemini on my phone with a local LLM, and it's a mobile upgrade I didn't expect
xda-developers.com/replaced-chatgpt-claude-gemini-on-phone-with-local-llm/
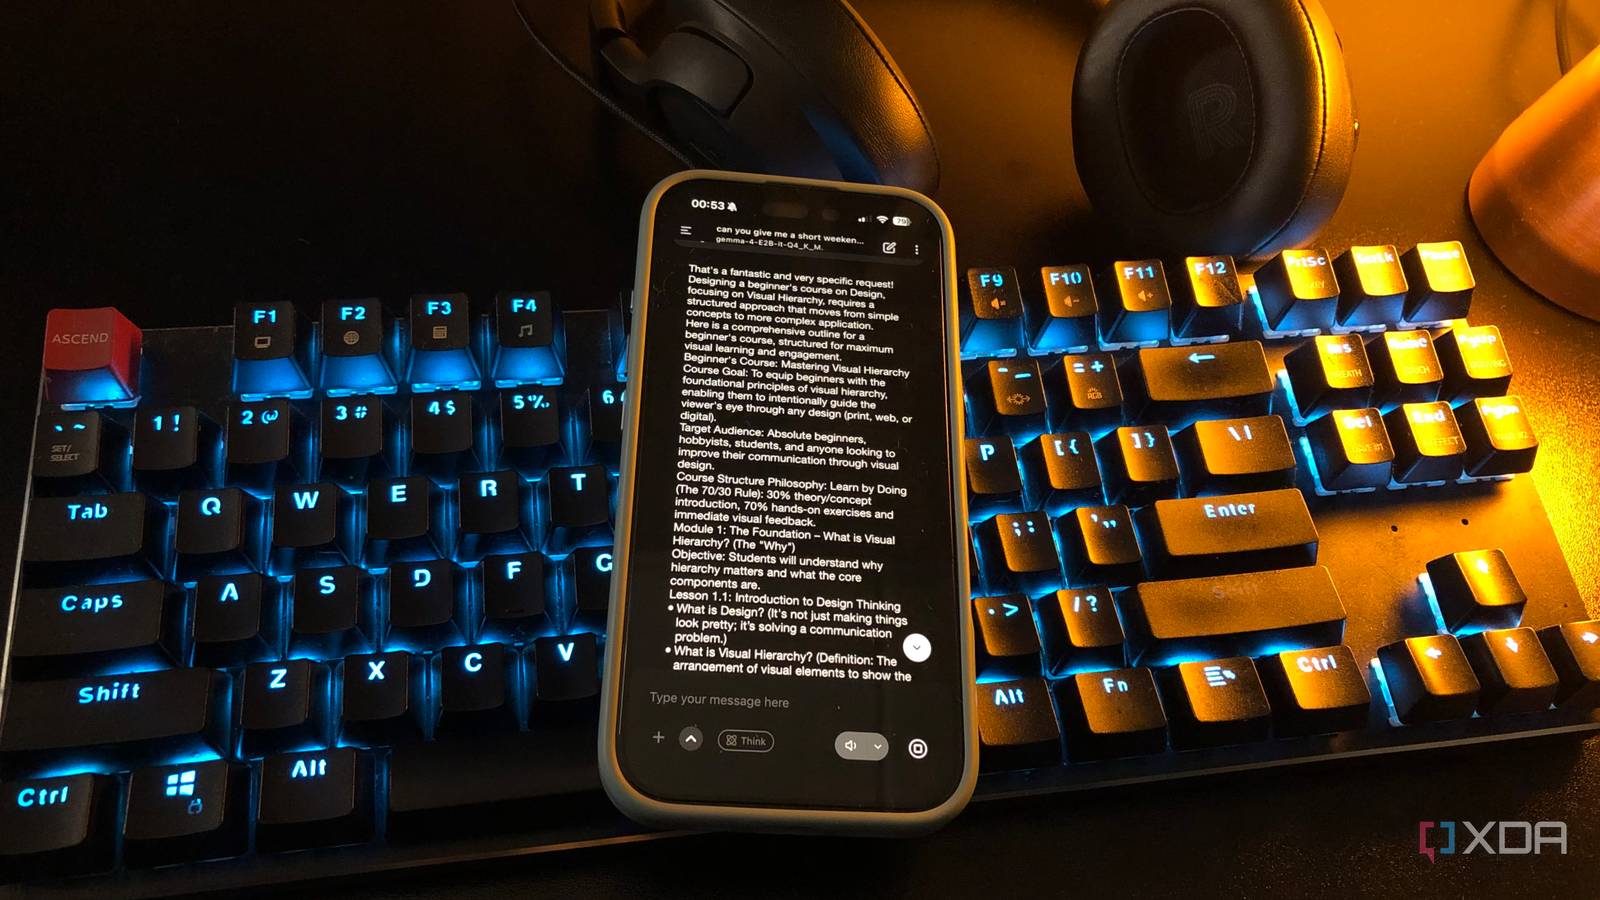
Ich habe drei kleine lokale LLMs für den täglichen Gebrauch getestet, und nur einer davon hat mich beeindruckt
xda-developers.com/tested-tiny-local-llms-for-everyday-work-only-one-impressed-me/
Googles kostenloses Gemma 4-Modell läuft auf Hardware, die Sie wahrscheinlich schon besitzen.
xda-developers.com/googles-free-gemma-4-model-runs-on-hardware-you-probably-already-own/

Google Gemma 4 12B erreicht fast die Benchmark-Werte von 26B – und läuft auf Ihrem Laptop
thenewstack.io/google-gemma-local-ai/


Google stellt DiffusionGemma vor, ein KI-Modell, das die traditionelle Leserichtung von links nach rechts durchbricht.
computerworld.com/article/4184675/google-unveils-diffusiongemma-an-ai-model-that-breaks-free-of-left-to-right-processing-2.html


Google kontert Apples KI-Fehler mit Local Gemma AI für Mac: Die App ist jetzt für Macs mit Apple Silicon Chips und macOS 14 oder neuer verfügbar.
extremetech.com/computing/google-challenges-apples-ai-missteps-with-local-gemma-ai-for-mac

club-3090/models/qwen3.6-27b/vllm/compose/dual/fp8/mtp.yml at master · noonghunna/club-3090
github.com/noonghunna/club-3090/blob/master/models/qwen3.6-27b/vllm/compose/dual/fp8/mtp.yml


Google AI Edge Gallery startet auf macOS und ermöglicht Mac-Nutzern die lokale Ausführung von Gemini-Modellen
9to5mac.com/2026/06/03/google-ai-edge-gallery-launches-to-macos-letting-mac-users-run-gemini-models-locally/

Googles neuestes On-Device-KI-Modell ist maßgeschneidert für Ihren Laptop: Google hat das multimodale agentenbasierte KI-Modell Gemma 4 12B veröffentlicht ...
androidauthority.com/google-gemma-4-12b-multimodal-ai-model-3674379/
Ich habe endlich ein lokales Open-Source-LLM gefunden, das tatsächlich mit Cloud-KI mithalten kann
xda-developers.com/found-open-source-local-llm-that-competes-with-cloud-ai-gemma-4/
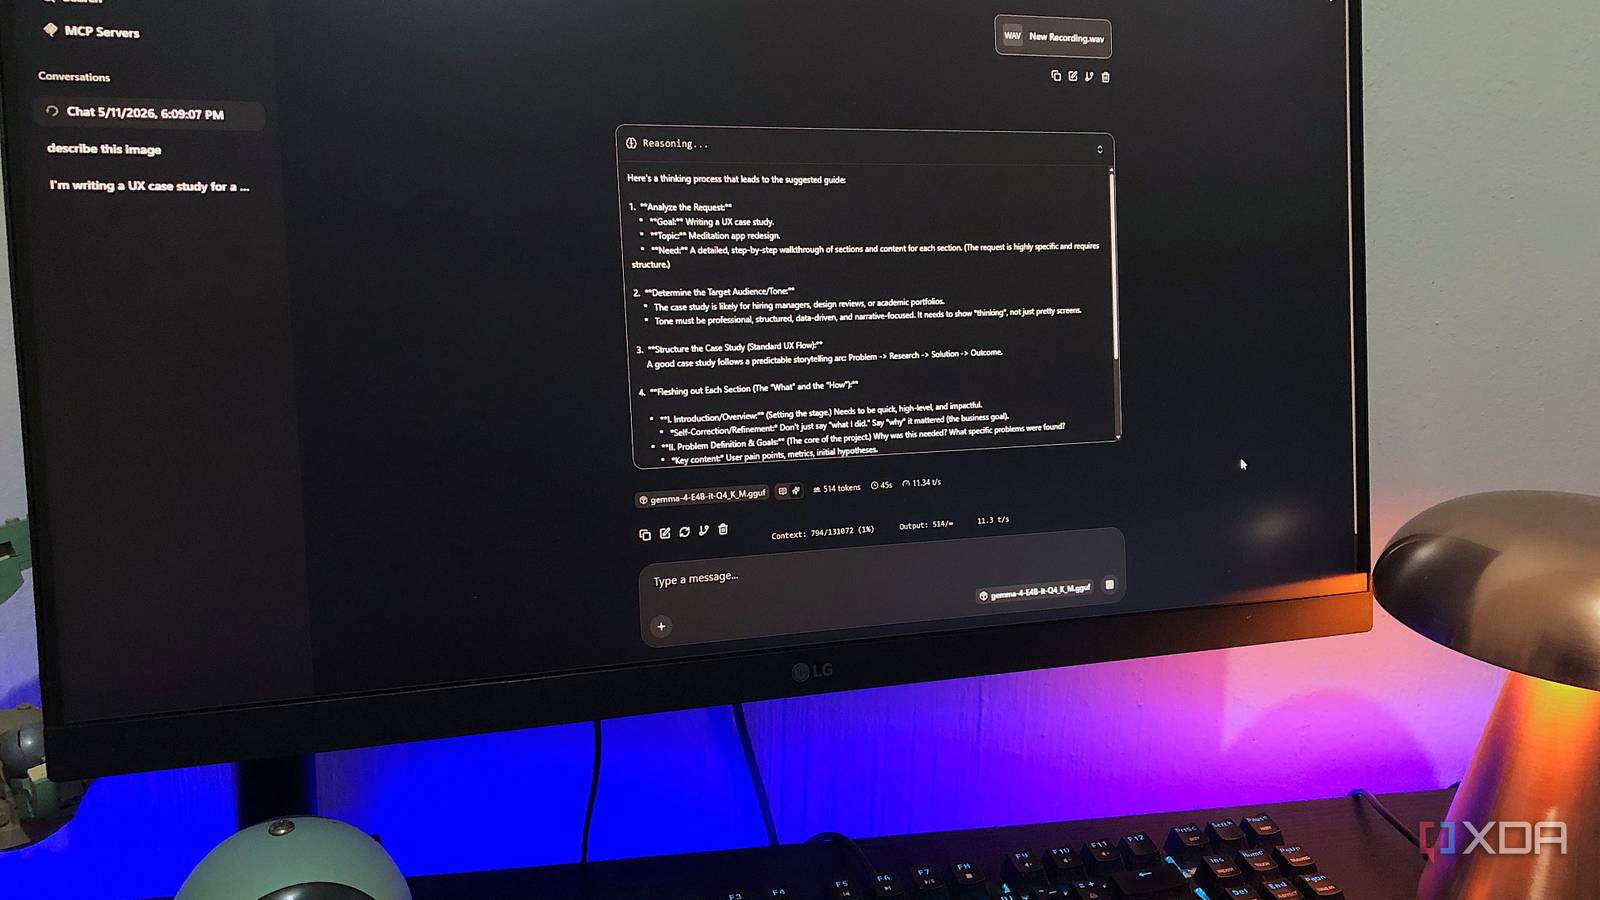
club-3090/models/qwen3.6-27b/vllm/compose/dual/carnice-bf16mtp/bf16-mtp.yml at master · noonghunna/club-3090
github.com/noonghunna/club-3090/blob/master/models/qwen3.6-27b/vllm/compose/dual/carnice-bf16mtp/bf16-mtp.yml

Ich habe drei kleine lokale LLMs für den täglichen Gebrauch getestet, und nur einer davon hat mich beeindruckt
xda-developers.com/tested-tiny-local-llms-for-everyday-work-only-one-impressed-me/
Ich habe LM Studio gegen llama.cpp getauscht, und mein lokales LLM fühlt sich nicht mehr wie ein Rückschritt an.
xda-developers.com/ditched-lm-studio-for-llama-cpp-and-local-llm-doesnt-feel-like-downgrade-anymore/
GitHub - unslothai/unsloth: Unsloth Studio is a web UI for training and running open models like Gemma 4, Qwen3.6, DeepSeek, gpt-oss locally.
github.com/unslothai/unsloth

llama : Gemma4 MTP von am17an hinzufügen · Pull Request #23398 · ggml-org/llama.cpp
github.com/ggml-org/llama.cpp/pull/23398

Ich habe endlich ein lokales Open-Source-LLM gefunden, das tatsächlich mit Cloud-KI mithalten kann
xda-developers.com/found-open-source-local-llm-that-competes-with-cloud-ai-gemma-4/