
GitHub - | neuromaniacMD/llm-bench: Cross-machine LLM benchmark: Apple Silicon (MLX) vs AMD GPUs (llama.cpp ROCm/Vulkan)
github.com/neuromaniacMD/llm-bench

Details zur Berichterstattung
| Zuletzt aktualisiert | |
| Artikel gesamt | 1 |
Hauptthemen

Sprachmodell, das mit großen Mengen von Texten erstellt wurde


Ähnliche Artikel
Previous

AMD FSR-Upscaling kommt auf Xbox Series X|S, PC-Handhelds, Vulkan und mehr: AMD erweitert seine FSR 4.1-Upscaling-Technologie auf Xbox Series X|S, PC-Handhelds ...
neowin.net/news/amd-fsr-upscaling-is-coming-to-xbox-series-xs-pc-handhelds-vulkan-and-more/
GitHub – achyudh/llama.cpp: LLM-Inferenz in C/C++: LLM-Inferenz in C/C++. Tragen Sie zur Entwicklung von achyudh/llama.cpp bei, indem Sie ein Konto auf GitHub ...
github.com/achyudh/llama.cpp


Apples große KI-Woche endet mit Mac + Muse KI-Supercomputern: Apple und Meta bringen Muse Spark Open auf Mac Studio, MLX erhält ein Upgrade und mehr.
computerworld.com/article/4236527/apples-big-ai-week-ends-with-mac-muse-ai-supercomputers.html

vulkan: fuse qwen4exp's SCALE -> SIGMOID -> SCALE -> hc_post chain by fxgsell · Pull Request #29520 · ggml-org/llama.cpp
github.com/ggml-org/llama.cpp/pull/29520

GitHub - | AMD-Ecosystem/llama.cpp: LLM-Inferenz in C/C++: LLM-Inferenz in C/C++. Beteiligen Sie sich an der Entwicklung von AMD-Ecosystem/llama.cpp ...
github.com/AMD-Ecosystem/llama.cpp

CI-Ziele für ROCm 7.14 von superm1 hinzugefügt · Pull Request #25775 · ggml.org/llama.cpp
github.com/ggml-org/llama.cpp/pull/25775

GitHub – tleyden/tauri2-local-llm: Prototyping der verschiedenen Möglichkeiten zum Ausführen eines lokalen LLM-Modells unter Tauri2
github.com/tleyden/tauri2-local-llm

vulkan: TP-Implementierung durch pwilkin · Pull Request #25051 · ggml-org/llama.cpp
github.com/ggml-org/llama.cpp/pull/25051

Verschiedene Bug: ROCm verwendet einen neuen DXG-Connector für WSL2, der ungewöhnliche Werte für freien Speicher liefert (wahrscheinlich kein Bug in llama.cpp ...
github.com/ggml-org/llama.cpp/issues/23999

Release b9387 · ggml.org/llama.cpp: LLM-Inferenz in C/C++. Beteiligen Sie sich an der Entwicklung von ggml-org/llama.cpp, indem Sie ein Konto auf GitHub ...
github.com/ggml-org/llama.cpp/releases/tag/b9387

Release b9406 · ggml-org/llama.cpp: LLM-Inferenz in C/C++. Beteiligen Sie sich an der Entwicklung von ggml-org/llama.cpp, indem Sie ein Konto auf GitHub ...
github.com/ggml-org/llama.cpp/releases/tag/b9406

GitHub - | Kaden-Schutt/hipfire: RDNA-native LLM-Inferenz-Engine in Rust.: RDNA-native LLM-Inferenz-Engine in Rust. . Beteilige dich an der Entwicklung von ...
github.com/Kaden-Schutt/hipfire

Release b8786 · ggml-org/llama.cpp: LLM-Inferenz in C/C++. Beteiligen Sie sich an der Entwicklung von ggml-org/llama.cpp, indem Sie ein Konto auf GitHub ...
github.com/ggml-org/llama.cpp/releases/tag/b8786


KI und wissenschaftliches Rechnen: Rocken mit Rocm - Golem.de: AMD-GPUs sind deutlich günstiger als Nvidia, und mit Rocm gibt es ein Cuda-Pendant. Wir zeigen ...
golem.de/news/amd-rocm-ki-und-wissenschaftliches-rechnen-mit-rocm-rocken-2604-207207.html

GitHub - | philtomson/llama.cpp: LLM-Inferenz in C/C++ (Fork des PrismML-Forks, der CPU-Unterstützung (inkl. AVX2 und AVX512) und ROCm für AMD-GPUs ermöglicht)
github.com/philtomson/llama.cpp
GitHub - | jimliddle/turboquant-amd-vulkan: Eine TurboQuant-Implementierung mit Llama.cpp für AMD mit Vulkan-Laufzeitumgebung
github.com/jimliddle/turboquant-amd-vulkan

GitHub - | thebeedubya/autoresearch: Ausführung von KI-Modellen mit 397 Milliarden Parametern auf einem 2500 US-Dollar teuren Strix Halo Desktop-PC. 128 GB UMA ...
github.com/thebeedubya/autoresearch

[Problem]: Leistungseinbußen bei llama.cpp in ROCm 7+ · Problem #2865 · ROCm/rocm-systems
github.com/ROCm/rocm-systems/issues/2865

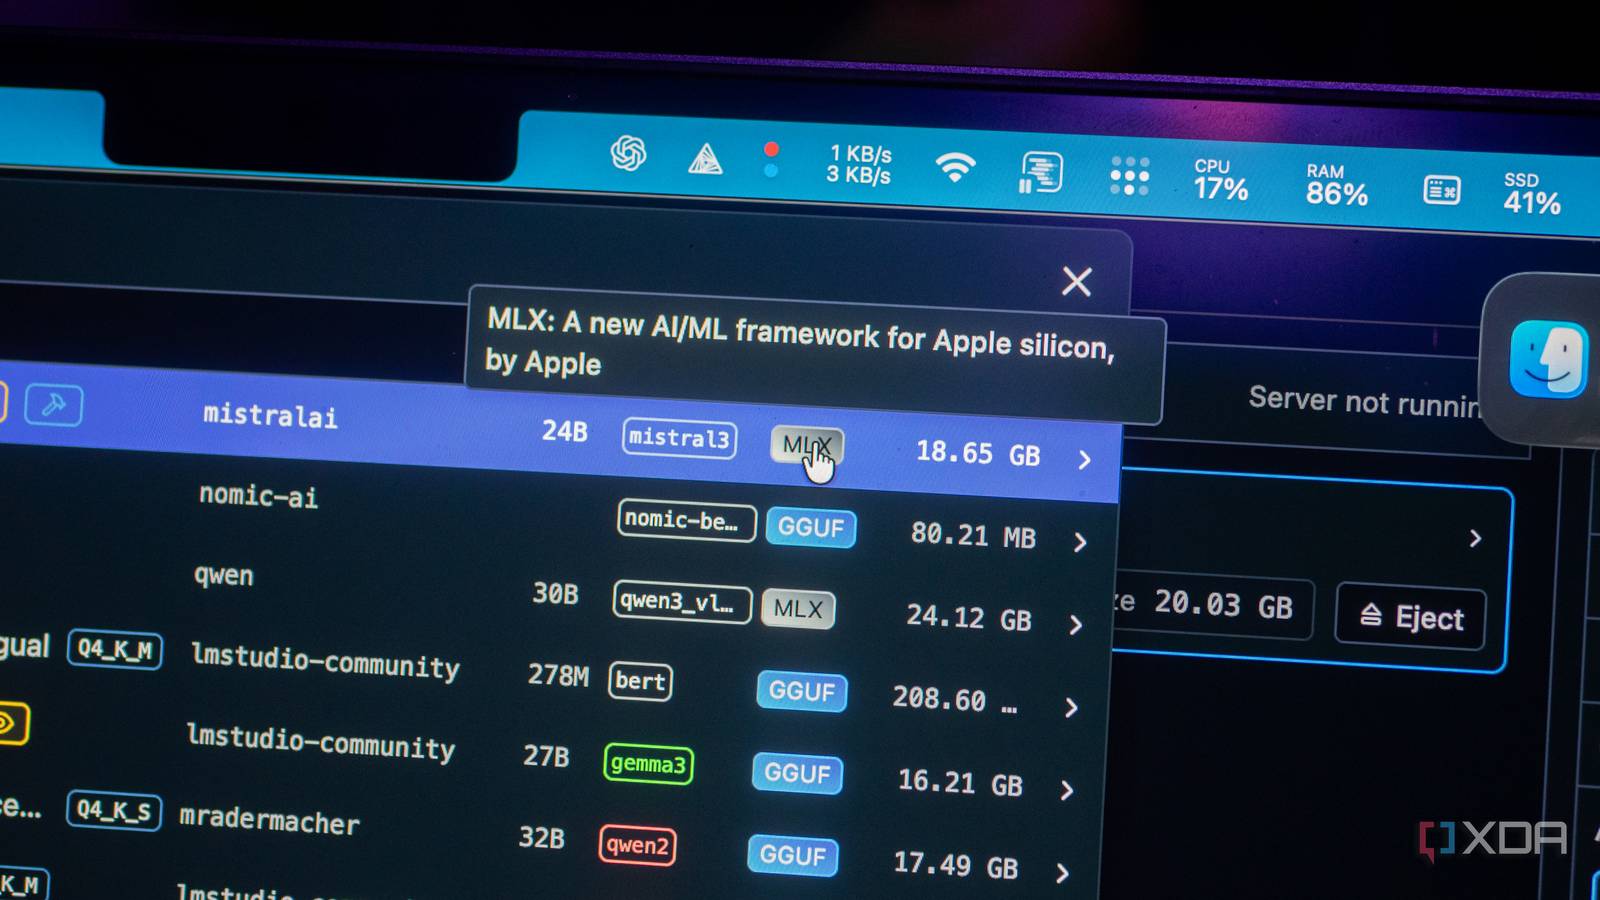
Apple hat einen unterschätzten Vorteil bei lokalen LLMs: Lokale LLMs profitieren von Apples Hardware, und das ist zu einem großen Teil MLX zu verdanken.
xda-developers.com/apple-sleeper-advantage-local-llms/

AMD fordert Nvidias CUDA AI-Software-Stack mit ROCm 7.0 heraus: Das Update verspricht bessere
extremetech.com/computing/amd-challenges-nvidia-cuda-ai-software-stack-with-rocm-70

Next